방화벽을 조이다 서비스를 멈췄다 — 밖에서 본 보안 점검과 7분 중단
운영 서버를 인터넷 쪽에서 점검했더니 클라우드 기본 방화벽이 모든 포트를 열어 두고 있었습니다. 방화벽을 좁히다 한 서비스를 7분 동안 멈춘 일과, 그 뒤 두 겹으로 막고 다시 검사한 과정을 적었습니다.
방화벽을 조이다 서비스를 멈췄다
밖에서 본 노출, 7분 중단, 그리고 두 겹 차단
왜 점검했나
Sandcorp의 공개 서비스는 대부분 클라우드의 운영 서버 한 대에서 돕니다. 서버 관리는 평소 사설망(VPN)으로 합니다. 그래서 「밖에서 보면 이 서버가 어떻게 보이는지」는 한 번도 제대로 본 적이 없었습니다.
2026-11-02에 운영 서버에 올라간 서비스 두 개를 정해 하루 동안 점검했습니다. 점검은 대표의 승인을 받고 했습니다.
- 밖에서만 봤습니다. 인터넷에 열린 면(포트, TLS, 보안 헤더, 애플리케이션 API)만 봤고, 서버 안의 설정은 보지 않았습니다.
- 망가뜨리지 않게 했습니다. 요청을 천천히 보냈고, 데이터를 바꾸는 시도는 하지 않았습니다.
- 두 곳에서 교차 확인했습니다. 사무실 회선과 다른 클라우드의 서버, 서로 다른 두 지점에서 봤습니다. 둘 다 사설망을 끊고 공개 인터넷 경로로만 접속했습니다. 경로 추적으로 사설망을 타지 않는 것도 확인했습니다.
사설망 안에서 보이는 서버와 인터넷에서 보이는 서버는 다릅니다. 공격자는 바깥에서 봅니다. 그래서 점검도 바깥에서 했습니다.
무엇을 찾았고, 어떻게 막았나
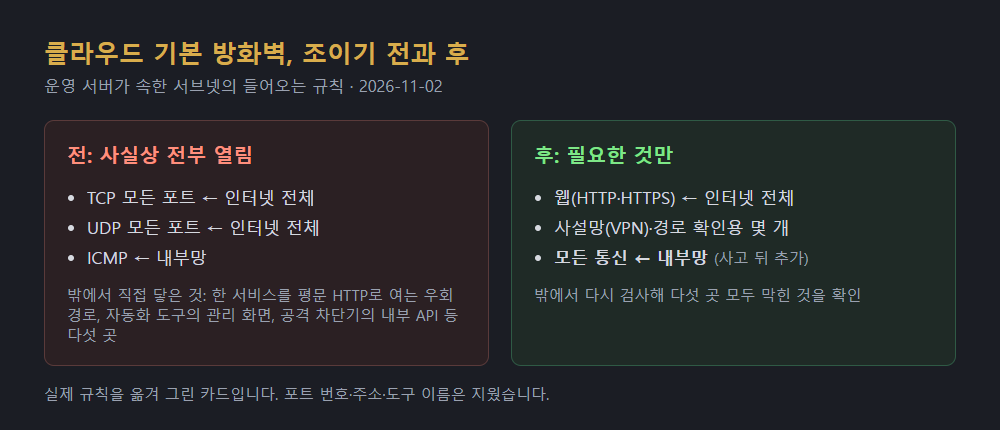
① 클라우드 기본 방화벽의 들어오는 규칙, 조이기 전과 후입니다. 실제 규칙을 옮겨 그린 카드이고, 포트 번호·주소·도구 이름은 지웠습니다.
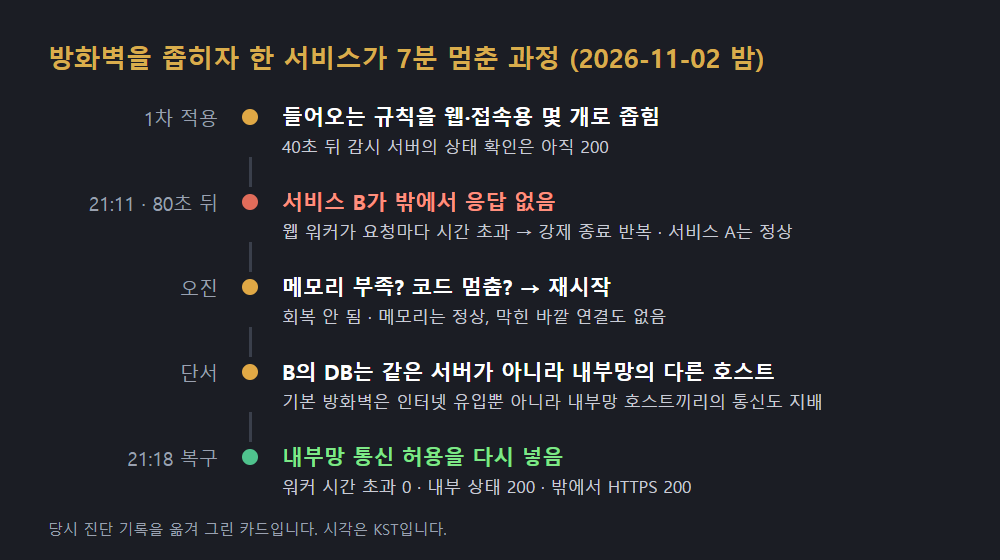
② 방화벽을 좁히다 한 서비스가 약 7분(21:11~21:18 KST) 멈춘 과정입니다. 당시 진단 기록을 옮겨 그린 카드입니다.
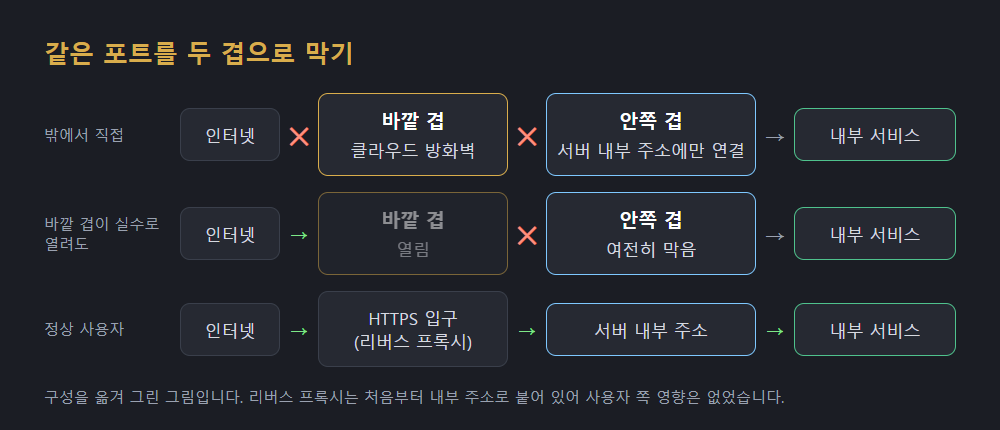
③ 같은 포트를 두 겹으로 막은 구조입니다. 구성을 옮겨 그린 그림입니다.
점검에서 재검사까지
- 밖에서 점검사설망을 끊고
두 지점에서 공개 경로로 포트·TLS·헤더·API를 본다
- 노출 발견원인: 기본 방화벽
웹 말고도 내부용 포트 다섯 곳이 밖에서 닿는다
- 방화벽 조이기되돌릴 수 있게
꼭 필요한 포트만 남긴다. 바꾸기 전 규칙은 파일로 백업한다
- 중단과 복구21:11~21:18
한 서비스가 7분 멈춤 → 내부망 통신 허용을 다시 넣는다
- 두 겹 차단방화벽이 열려도 막힘
컨테이너 포트를 서버 내부 주소에만 연결한다
- 밖에서 재검사같은 두 지점에서
다섯 곳 모두 막혔고, 사이트는 모두 정상
점검한 것과 결과
| 점검한 것 | 결과 | 상태 |
|---|---|---|
| 밖에서 열린 포트 | 웹 말고도 내부용 포트 다섯 곳이 열려 있었다 | 고침 |
| TLS·보안 헤더 | TLS 1.3, HSTS, 다른 사이트에 끼워 넣기 방지 헤더가 있었다 | 문제 없음 |
| 민감한 API | 전부 로그인을 요구했다(401). 남의 ID를 넣는 시도도 401 | 문제 없음 |
| CORS | 모든 출처를 허용하지만 자격 증명은 허용하지 않는다(위젯용) | 문제 없음 |
| 숨은 파일·관리 화면 | 설정 파일, 저장소 폴더, 디버그 화면이 밖에 보이지 않았다 | 문제 없음 |
- 점검한 두 서비스를 합쳐 적었습니다.
부딪힌 문제와 해결
1. 기본 방화벽이 전부 열려 있었다
밖에서 포트를 훑어보니 웹(80·443) 말고도 여러 포트가 응답했습니다. 다섯 곳이 열려 있었습니다. 한 서비스를 HTTPS 입구 없이 평문 HTTP로 바로 여는 우회 경로, 자동화 도구의 관리 화면, 공격 차단기의 내부 API 등입니다. 우회 경로로 들어오면 TLS, 보안 헤더, 공격 차단을 모두 건너뜁니다. 다행히 그 경로에서도 애플리케이션이 로그인을 요구해서, 데이터가 바로 새지는 않았습니다.
원인은 두 가지가 겹친 것이었습니다.
- 클라우드가 처음 만들어 준 기본 방화벽 규칙이 모든 TCP·UDP를 인터넷 전체에 허용하고 있었습니다.
- 컨테이너 포트를 서버의 모든 네트워크 주소에 연결해 두었습니다. 리버스 프록시만 쓰면 되는 포트였는데, 밖에서도 닿았습니다.
→ 방화벽의 들어오는 규칙을 웹과 꼭 필요한 몇 개로 줄였습니다(위 ① 카드). 바꾸기 전 규칙은 파일로 백업해 두었습니다.
2. 방화벽을 좁히자 한 서비스가 7분 멈췄다
규칙을 적용하고 40초 뒤까지는 감시 서버의 상태 확인이 정상이었습니다. 80초쯤 지나자 서비스 하나(아래 B)가 밖에서 응답하지 않았습니다. 다른 서비스(A)는 멀쩡했습니다. B의 웹 워커는 요청마다 시간 초과로 강제 종료되고 있었고, 로그에는 「메모리가 부족한 것 아니냐」는 경고가 반복됐습니다.
처음에는 애플리케이션 문제로 봤습니다. 메모리 부족이나 코드가 멈춘 것을 의심해 재시작했지만 회복되지 않았습니다. 메모리는 512MB 중 140MB로 정상이었고, 막힌 포트로 나가려다 멈춘 연결도 없었습니다.
단서는 B의 설정에 있었습니다. B의 DB는 같은 서버가 아니라 내부망의 다른 호스트에 있었습니다. 클라우드의 기본 방화벽은 인터넷에서 들어오는 통신뿐 아니라 같은 내부망 호스트끼리의 통신도 함께 다룹니다. 바깥 유입을 좁히면서 DB로 가는 길까지 막은 것입니다. 기존 DB 연결이 살아 있던 40초 남짓은 버텼고, 그 뒤 쿼리가 하나씩 멈추면서 워커가 시간 초과로 죽었습니다. A는 DB가 같은 서버의 컨테이너라 영향이 없었습니다.
→ 내부망 대역의 통신 허용을 다시 넣었습니다. 21:18에 B가 회복했습니다. 워커 시간 초과가 사라졌고, 서버 안 상태 확인과 밖에서 본 HTTPS가 모두 200이었습니다. 멈춘 시간은 21:11부터 약 7분입니다.
교훈은 두 가지입니다.
- 클라우드 방화벽을 좁힐 때는 내부망 통신 허용을 먼저 남깁니다. DB와 캐시가 같은 서버에 있다는 보장이 없습니다.
- 서비스가 죽으면 재시작하기 전에 DB·캐시로 가는 네트워크 경로부터 봅니다. 「메모리 부족?」 같은 로그 문구에 끌려가면 엉뚱한 곳을 고치게 됩니다.
3. 한 겹만 믿지 않기
방화벽으로 막았지만, 원인 중 하나였던 「모든 주소에 연결된 컨테이너 포트」는 그대로였습니다. 누군가 방화벽 규칙을 다시 넓히면 같은 포트가 또 열립니다.
→ 내부용 컨테이너 포트를 전부 서버 내부 주소(도커 브리지 게이트웨이)에만 연결하게 바꿨습니다(위 ③ 그림). 이제 방화벽이 열려도 밖에서는 닿지 않습니다. 리버스 프록시는 처음부터 이 내부 주소로 붙어 있어서 사용자 쪽 영향은 없었습니다. 점검한 서비스 하나는 이미 이렇게 되어 있었고, 나머지를 같은 모양으로 맞췄습니다.
한 서비스는 배포 스크립트가 설정 파일 내용이 바뀔 때만 프록시 컨테이너를 다시 만들었습니다. 포트 연결만 바꾼 이번 변경은 감지하지 못해서, 한 번은 손으로 다시 만들었습니다. 한 번 다시 만든 뒤로는 바뀐 연결이 유지됩니다.
마지막으로 처음과 같은 두 지점에서 다시 검사했습니다. 다섯 곳 모두 막혔고, 운영 사이트는 모두 정상으로 응답했습니다. 점검, 조치, 재검사가 하루 안에 끝났습니다.
그 밖에 해 둔 것
이번 점검 전인 10월 하순에도 작은 보안 조치를 몇 가지 했습니다.
- 비밀값을 한곳에 모았습니다. 개발용 자격 증명의 원본을 한곳에 두고, 서버에 흩어져 있던 사본은 지웠습니다.
- LLM API 키를 서비스별로 나눴습니다. 서비스마다 전용 키를 쓰고, 월 사용 한도를 넘으면 요청이 거부되게 했습니다. 80%와 100%에 이르면 알림이 옵니다.
- 설정 권한을 나눴습니다. 한 서비스에서 일반 구성원도 키와 외부 연동을 바꿀 수 있었습니다. 이것을 관리자 전용으로 바꾸고, 구성원은 읽기만 하게 했습니다.
- 쓰지 않는 이름을 지웠습니다. 더는 쓰지 않는 도메인의 DNS 레코드와 웹훅을 정리했습니다.