배포 스크립트가 자기 자신을 덮어써 운영 서버가 멈춘 날 — 원인 추적부터 재발 방지·자동 대응까지
로그를 남기려던 작은 파이프라인 변경이 배포 스크립트를 「자기 자신 실행」 한 줄로 덮어썼고, 무한 재귀가 2분 만에 운영 서버 메모리를 다 먹었습니다. 원인을 찾아간 길과 네 겹의 재발 방지, 사전 검사 뒤에 AI 에이전트를 깨우는 자동 대응을 적었습니다.
배포 스크립트가 자기 자신을 덮어쓴 날
원인 추적부터 재발 방지·자동 대응까지
배경 — 한 서버에 서비스와 빌드 에이전트가 함께
샌드코프의 운영 서버 한 대에는 홈페이지와 Codemit·Daypage·Flow 같은 서비스가 함께 올라가 있습니다. 배포를 그 서버에서 바로 하기 위해, 같은 서버에 CI 빌드 에이전트 컨테이너도 하나 떠 있습니다. 저장소마다 배포 절차를 따로 쓰지 않고, 여러 저장소가 공유 파이프라인 라이브러리 하나를 불러 검사·이미지 굽기·배포를 합니다.
2026년 11월 4일 오후, 이 공유 파이프라인에 들어간 작은 변경 하나 때문에 운영 서버 전체가 약 8분 동안 응답하지 않았습니다. 17:05에 홈페이지 배포가 시작됐고, 2분 뒤에는 서버 메모리가 97%까지 찼습니다. 모든 서비스가 15초 시간 초과로 떨어졌고, 17:14에 클라우드 CLI로 서버를 강제 재부팅한 뒤 17:15에 전 서비스가 정상으로 돌아왔습니다.
이 글은 원인을 어떻게 찾았는지, 같은 일이 다시 생기지 않게 무엇을 바꿨는지, 그리고 다음에 비슷한 일이 생기면 사람이 보기 전에 무엇이 먼저 움직이게 했는지에 대한 기록입니다.
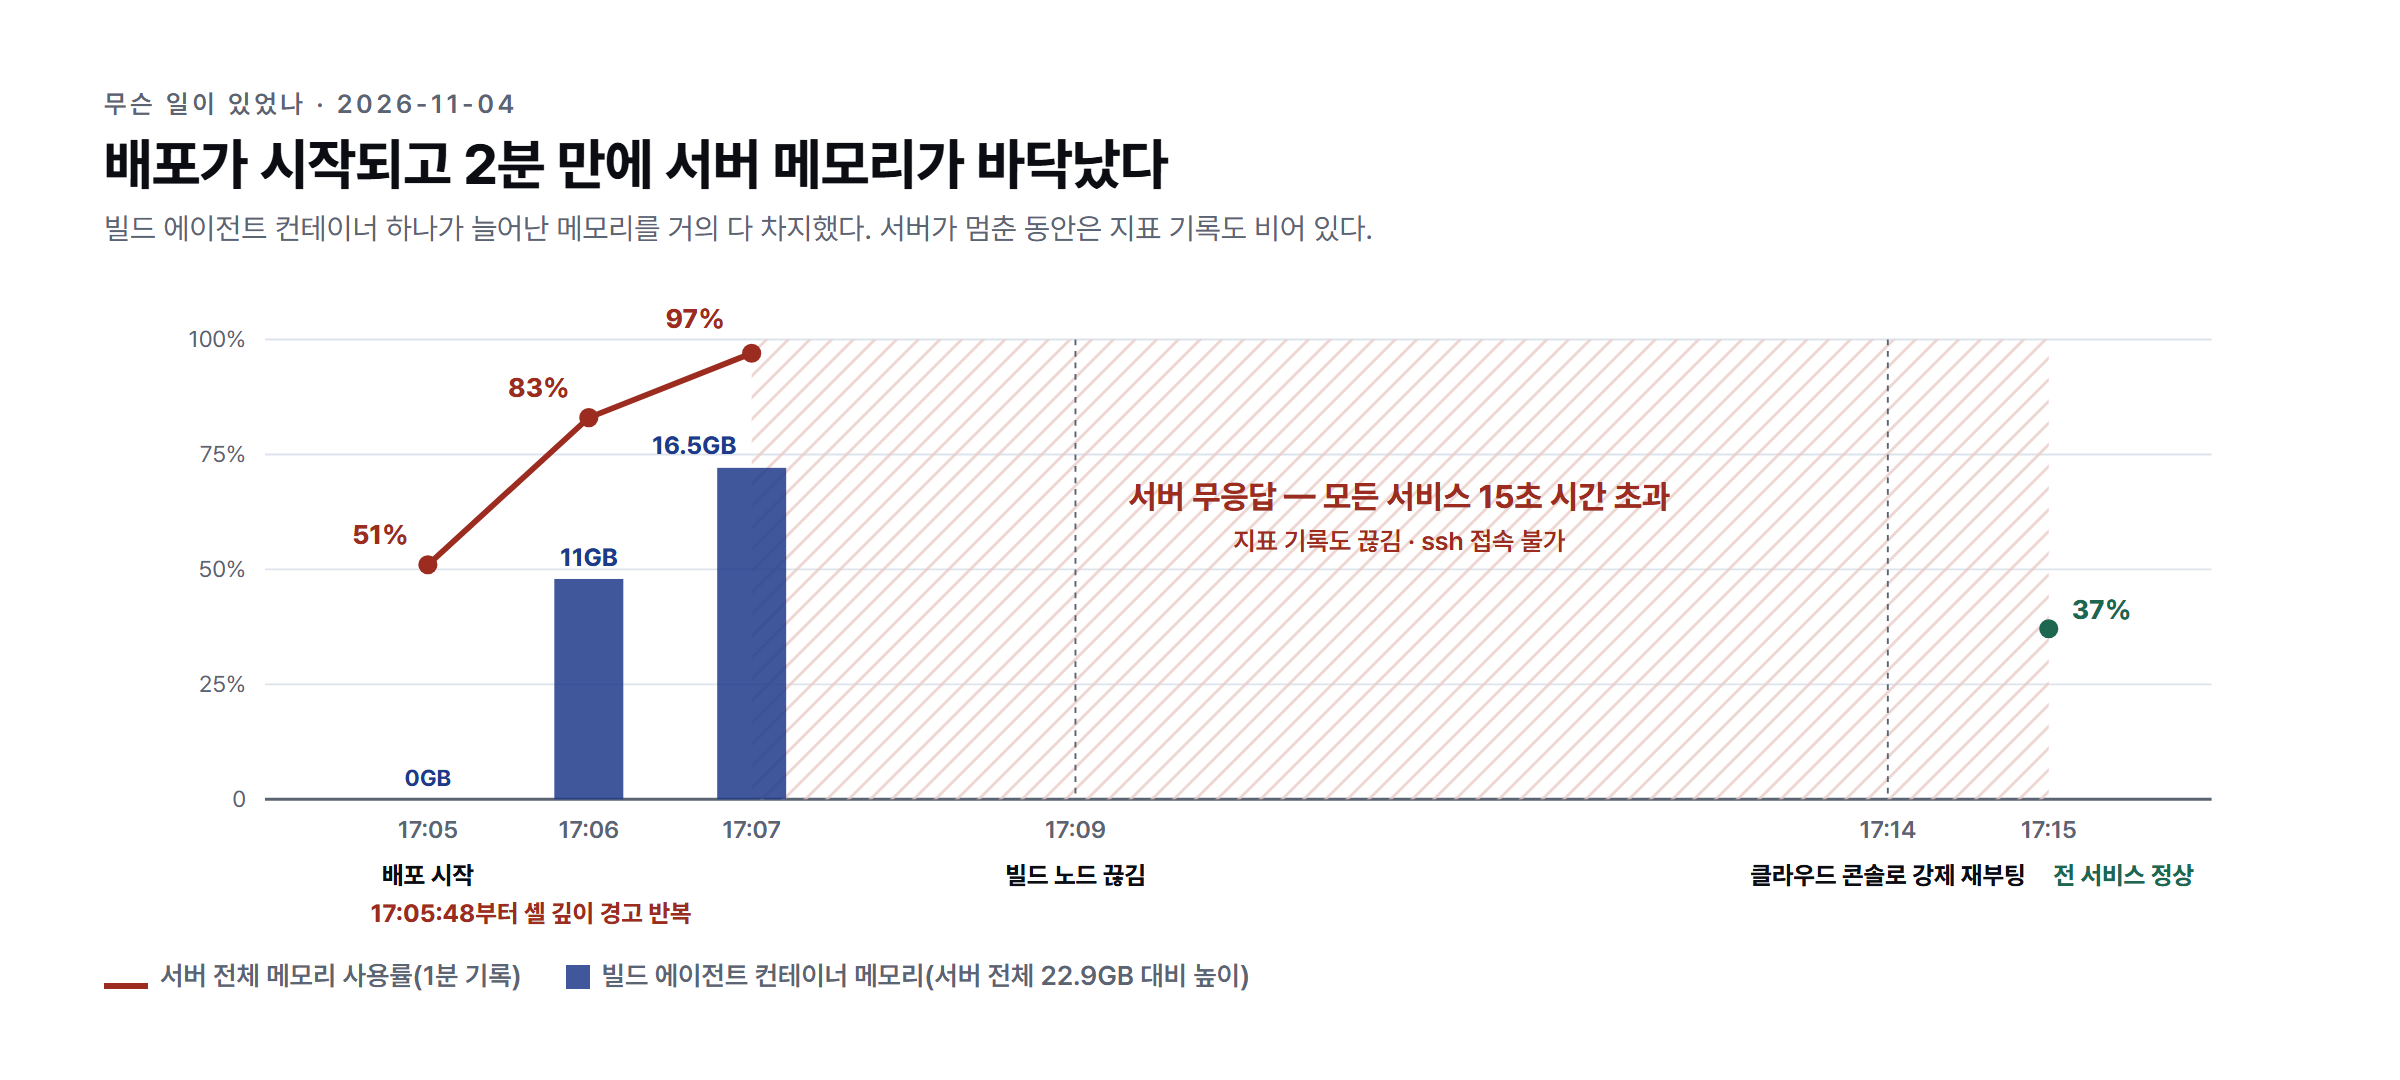
배포 시작 뒤 2분 동안 빌드 에이전트 컨테이너 하나가 늘어난 메모리를 거의 다 차지했습니다. 서버 지표 기록(1분 간격)의 값을 옮겨 그린 그림이며, 서버가 멈춘 구간은 기록이 없습니다.
원인을 찾아간 길
- 외부 상태 점검
응답 시간과 인증서 조건이 여러 서비스에서 동시에 실패한다는 알림
- 서버 지표
메모리가 17:05~17:07 사이에 51% → 97%로 급증한 시점
- 컨테이너별 메모리범인
늘어난 양 거의 전부가 빌드 에이전트 컨테이너 하나
- CI 콘솔
배포 단계 직후부터 「shell level (1000) too high」 경고 반복
- 공유 라이브러리 코드원인
명령 파일 경로와 배포 스크립트 경로가 같다
무엇이 문제였나
증상
처음 온 신호는 외부 상태 점검 알림이었습니다. 한 서비스가 아니라 그 서버에 올라간 서비스들이 한꺼번에 응답 시간 조건과 인증서 조건에서 실패했습니다. 인증서가 갑자기 잘못됐을 리는 없으니, 응답 자체가 오지 않는다는 뜻이었습니다. ssh도 붙지 않았습니다.
서버 지표 기록을 보니 메모리가 17:05에 51%, 17:06에 83%, 17:07에 97%였고, 그 뒤로는 기록이 끊겨 있었습니다. 컨테이너별 기록에서는 빌드 에이전트 컨테이너가 2분 사이에 0에서 11GB, 다시 16.5GB로 늘어 있었습니다. 17:07까지 10분 동안 서버 전체에서 늘어난 메모리 약 16.3GB 가운데 거의 전부가 이 컨테이너 몫이었습니다.
그 시각 그 노드에서는 홈페이지 배포가 돌고 있었습니다. CI 콘솔에는 배포 단계가 배포 스크립트를 부른 직후부터 이 줄이 약 2초 간격으로 끝없이 찍혀 있었습니다.
bash: warning: shell level (1000) too high, resetting to 1
셸이 셸을 1000단계 넘게 띄우고 있다는 뜻입니다. bash는 이 경고를 낸 뒤 깊이 값을 1로 되돌릴 뿐 실행을 멈추지 않습니다. 셸 프로세스가 계속 쌓이면서 메모리를 먹었습니다.
원인 — 로그를 남기려던 명령 파일이 배포 스크립트를 덮어썼습니다
얼마 전 공유 파이프라인에 기능 하나가 들어갔습니다. 배포가 실패하면 실패한 줄을 병합 PR에 댓글로 달아 주는 기능입니다. 그러려면 단계 출력을 화면에 보여 주는 동시에 파일로도 남겨야 합니다. 그래서 단계 명령을 임시 파일에 적고, sh -xe 파일 | tee 로그로 실행하는 래퍼를 만들었습니다.
문제는 그 임시 파일의 이름이었습니다. 래퍼는 명령 파일을 sandcorp-{단계}.sh라는 규칙으로 지었습니다. 검사 단계는 sandcorp-check.sh, 이미지 굽기 단계는 sandcorp-image.sh라 아무 일이 없었습니다. 그런데 배포 단계의 이름은 deploy였고, 배포 단계가 실제로 돌리는 스크립트가 바로 같은 임시 폴더의 sandcorp-deploy.sh였습니다.
배포 단계의 명령은 「sandcorp-deploy.sh를 실행하라」는 한 줄입니다. 래퍼가 이 한 줄을 sandcorp-deploy.sh에 적는 순간 원래 배포 스크립트는 사라지고, 그 파일은 자기 자신을 부르는 한 줄이 됩니다. 실행하면 bash가 bash를 부르고, 그 bash가 또 bash를 부릅니다.
왜 커널이 막아 주지 못했나
리눅스에는 메모리가 바닥나면 프로세스를 골라 죽이는 커널 OOM 킬러가 있습니다. 하지만 커널 OOM 킬러는 할당이 정말로 실패할 때에야 움직입니다. 그 직전까지 커널은 캐시와 실행 파일 페이지를 버리고 다시 읽기를 되풀이하고, 이 구간에서 서버는 살아 있지만 아무 일도 하지 못합니다. 이번에는 17:07부터 17:14까지 그 상태로 스스로 돌아오지 못했고, 결국 클라우드 쪽에서 재부팅했습니다.
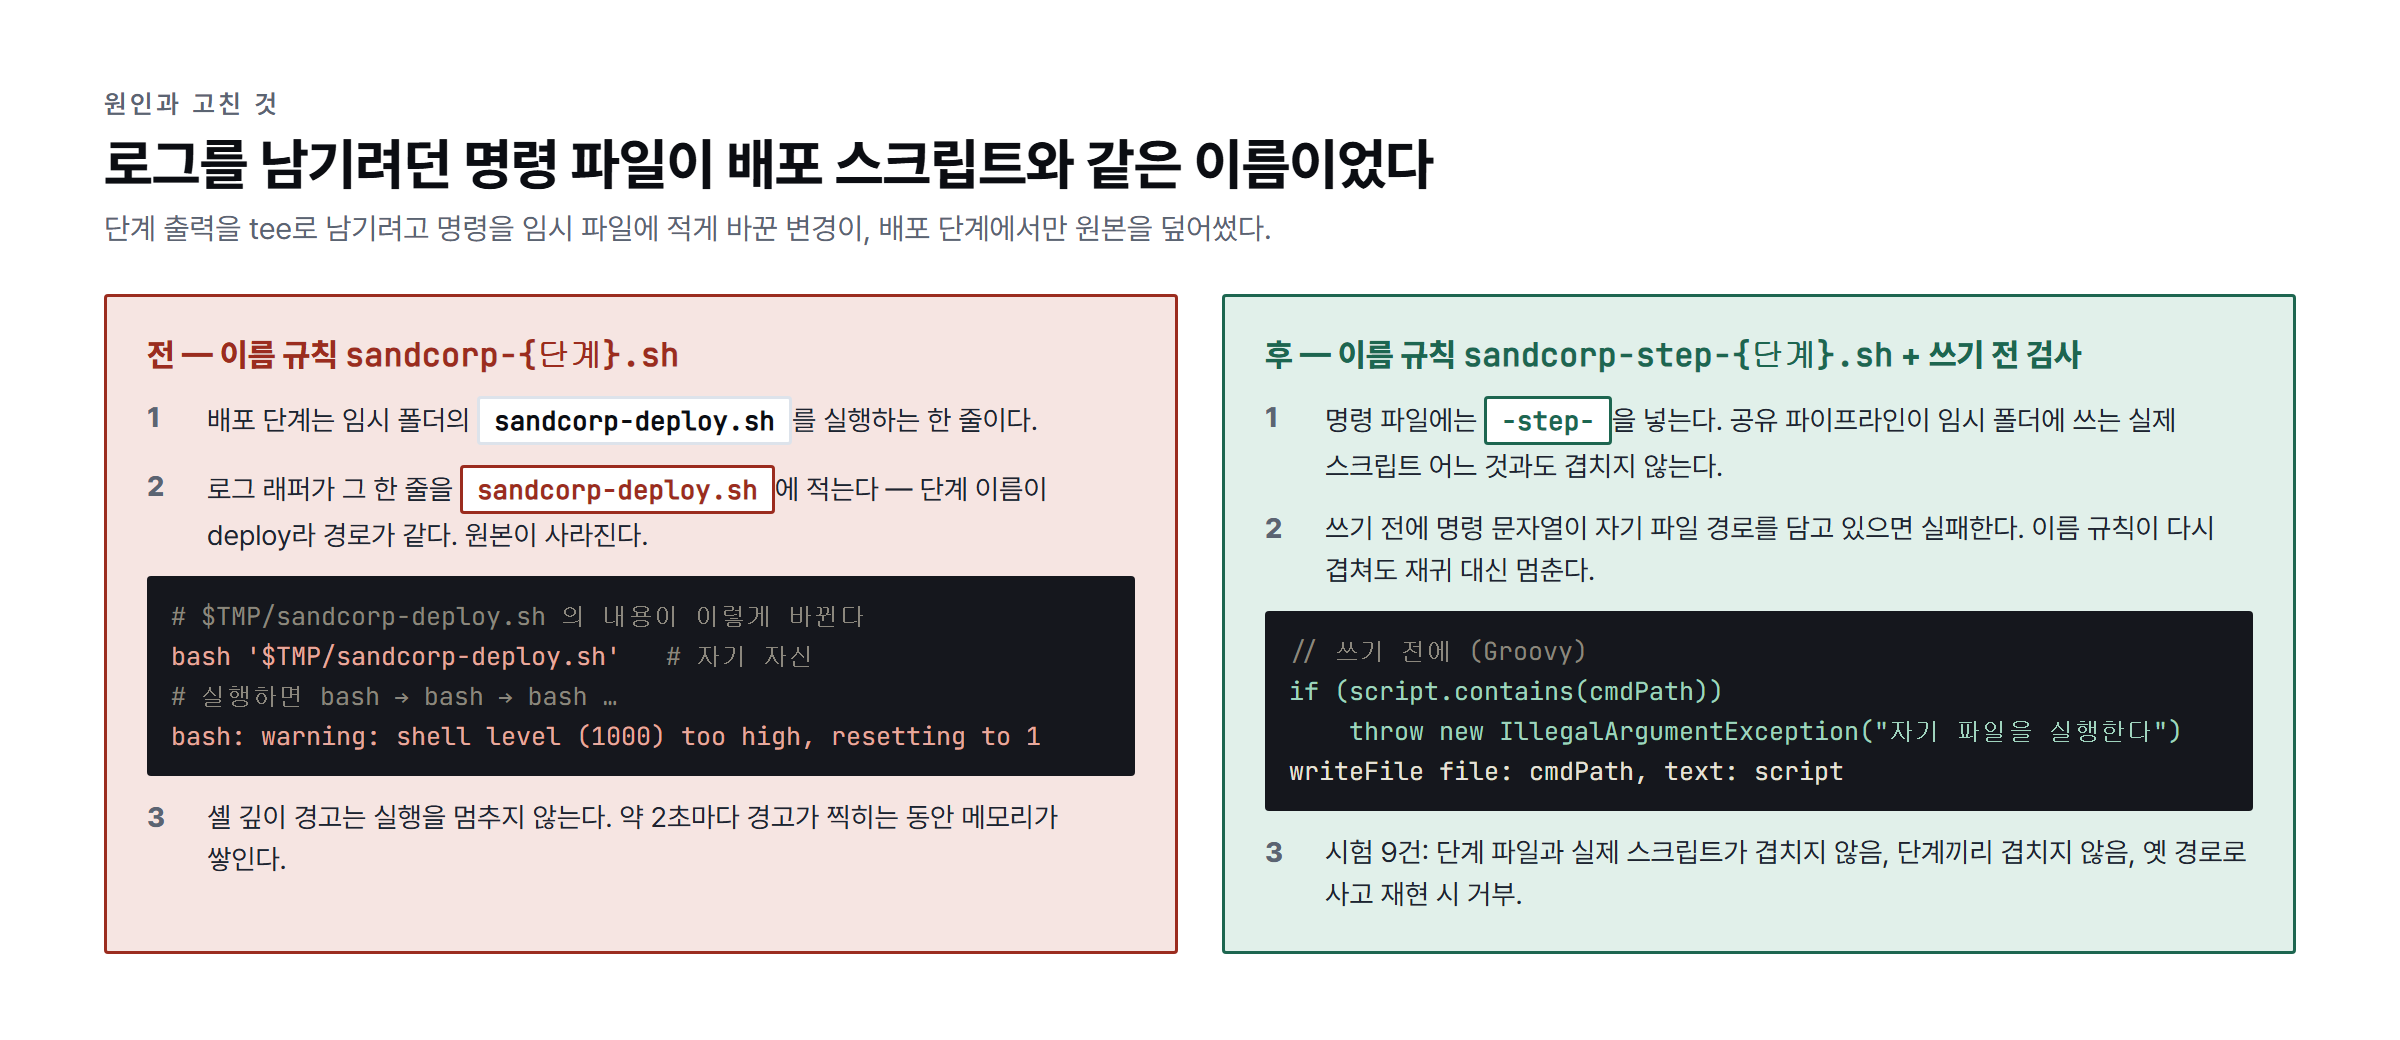
원인과 고친 것의 전후. 공유 라이브러리의 실제 파일 이름과 검사 방식을 옮겨 단순하게 그린 그림입니다.
고른 방법과 이유
1. 이름 규칙을 바꾸고, 그래도 겹치면 쓰기 전에 멈춥니다
먼저 명령 파일 이름에 -step-을 넣었습니다. 이제 배포 단계의 명령 파일은 sandcorp-step-deploy.sh이고, 공유 라이브러리가 임시 폴더에 쓰는 실제 스크립트 어느 것과도 이름이 겹치지 않습니다. 다른 단계도 하나씩 대조해 봤는데, 충돌이 있었던 것은 배포 단계 하나뿐이었습니다.
이름 규칙만으로는 부족하다고 봤습니다. 나중에 누군가 단계 이름이나 스크립트 이름을 바꾸면 또 겹칠 수 있습니다. 그래서 명령을 파일에 쓰기 전에, 명령 문자열이 자기 파일 경로를 담고 있으면 실패하게 했습니다. 다시 겹치더라도 무한 재귀 대신 「단계 명령이 자기 파일을 실행한다」는 오류로 배포가 멈춥니다.
여기에 시험 9건을 붙였습니다. 단계 파일이 실제 스크립트와 겹치지 않는지, 단계끼리 겹치지 않는지, 옛 경로로 사고를 재현하면 거부되는지를 봅니다.
셸 깊이나 재진입 표시 환경변수로 재귀를 감지해 끊는 방법도 검토했습니다. 하지만 그 방법은 재귀가 이미 시작된 뒤에 멈추고, 그때는 원본 스크립트가 이미 덮어써진 뒤입니다. 덮어쓰기 자체를 막는 쪽이 원인을 바로 가리키고 고장도 덜 남깁니다.
2. 서버가 멈추기 전에 「죽어도 되는 것」부터 끝냅니다
코드를 고쳐도, 빌드 에이전트가 운영 서버에 있는 한 다른 이유로 같은 폭주가 날 수 있습니다. 그래서 서버 쪽에도 세 겹을 더했습니다.
- earlyoom: 남은 메모리가 6% 아래로 내려가면 사용자 공간에서 먼저 프로세스를 끝냅니다. 커널 OOM 킬러보다 훨씬 이른 시점이라, 서버가 무응답 구간에 들어가기 전에 움직입니다. DB와 ssh, 컨테이너 엔진처럼 죽으면 더 큰일인 프로세스는 피하게 했습니다.
- oom_score_adj=1000: 빌드 에이전트와 헤드리스 브라우저처럼 운영 서비스가 아닌 컨테이너의 프로세스에 가장 높은 점수를 줘서, earlyoom이든 커널이든 이쪽을 1순위로 고르게 했습니다. 컨테이너가 다시 떠도 빠지지 않게 타이머로 주기적으로 다시 매깁니다.
- 빌드 에이전트 메모리 상한 4GB: 상한이 있으면 폭주가 그 컨테이너 안에서 끝납니다. 이번 사고는 상한이 없어서 컨테이너 하나가 16.5GB까지 커질 수 있었습니다.
재발 방지 네 겹
| 겹 | 무엇을 | 막는 것 |
|---|---|---|
| 파이프라인 코드 | 명령 파일 이름에 -step-, 쓰기 전 자기 경로 검사, 시험 9건 | 이번과 같은 덮어쓰기와 자기 재귀 |
| 빌드 에이전트 상한 | 컨테이너 메모리 4GB | 한 컨테이너의 폭주가 서버 전체로 번지는 것 |
| 우선순위 | 비운영 컨테이너 oom_score_adj=1000 | 메모리가 모자랄 때 운영 서비스가 먼저 죽는 것 |
| earlyoom | 남은 메모리 6%에서 먼저 종료 | 커널이 늦게 움직이는 동안 서버가 무응답이 되는 것 |
- 아래 세 겹(상한·우선순위·earlyoom)은 코드 말고 다른 원인으로 생긴 폭주에도 듣게 겹쳐 둔 것입니다. 하나가 빠져도 다음 겹이 받습니다.
자동 대응 — 사람보다 먼저 움직이는 것
이번에는 사람이 알림을 보고, 지표를 찾아보고, 클라우드 CLI로 재부팅했습니다. 다음에 비슷한 일이 생기면 사람이 보기 전에 무엇이 먼저 움직이게 하고 싶었습니다. 다만 AI 에이전트를 5분마다 깨워 「서버 괜찮은지 봐」라고 하면, 거의 모든 실행이 「정상」을 확인하는 데 토큰과 시간을 씁니다. 그래서 판단과 대응을 나눴습니다.
판단은 5분마다 도는 셸 스크립트
사전 검사 스크립트가 5분마다 세 가지 신호를 모읍니다. 서버 메모리가 92% 이상인지, 외부 상태 점검이 여러 개 실패하는지, 최근 6분 안에 earlyoom이나 커널이 프로세스를 끝낸 기록이 있는지입니다. 결과는 종료 코드 하나로만 냅니다. 이상이면 0, 정상이거나 판단할 수 없으면 1입니다.
- 0을 낼 때는 어떤 신호가 몇이었는지 근거 파일에 적습니다. 에이전트는 그 파일부터 읽습니다.
- 한 번 깨웠으면 20분은 다시 깨우지 않습니다. 대응하는 동안 재부팅 때문에 신호가 계속 뜨기 때문입니다.
- 서버 접속 실패 하나만으로는 깨우지 않습니다. 네트워크가 잠깐 끊긴 것일 수 있어서, 다른 신호가 같이 있을 때만 깨웁니다.
대응은 깨어난 AI 에이전트가 절차서대로
깨어난 에이전트는 절차서를 순서대로 끝까지 수행합니다. 사람에게 묻지 않습니다. 그 대신 절차서에 무엇을 언제 해도 되는지를 숫자로 적어 두었습니다.
- 긴급 알림을 가장 먼저, 1분 안에 보냅니다. 조사보다 앞입니다.
- 상태를 판단합니다. 최근 10분 동안 메모리가 가장 많이 는 컨테이너를 용의자로 고릅니다.
- 재부팅은 3분 동안(30초 간격 6번) 접속이 안 되고 서비스가 3개 이상 실패할 때만, 한 번만 합니다. 인스턴스 삭제나 설정 변경은 하지 않습니다.
- 용의자를 멈추는 것은 비운영 목록에 있는 컨테이너만 바로 합니다. 운영 컨테이너는 혼자서 메모리 증가의 절반 이상을 차지하고 4GB 넘게 늘었을 때만 멈추고, DB·캐시·프록시는 멈추지 않습니다.
- 원인을 조사합니다. 로그와 빌드 기록에서 근거를 모으고, 코드는 고치지 않습니다. 고칠 곳은 추정해 보고에 적습니다.
- 복구를 확인하고, 7. 결과를 보고합니다.
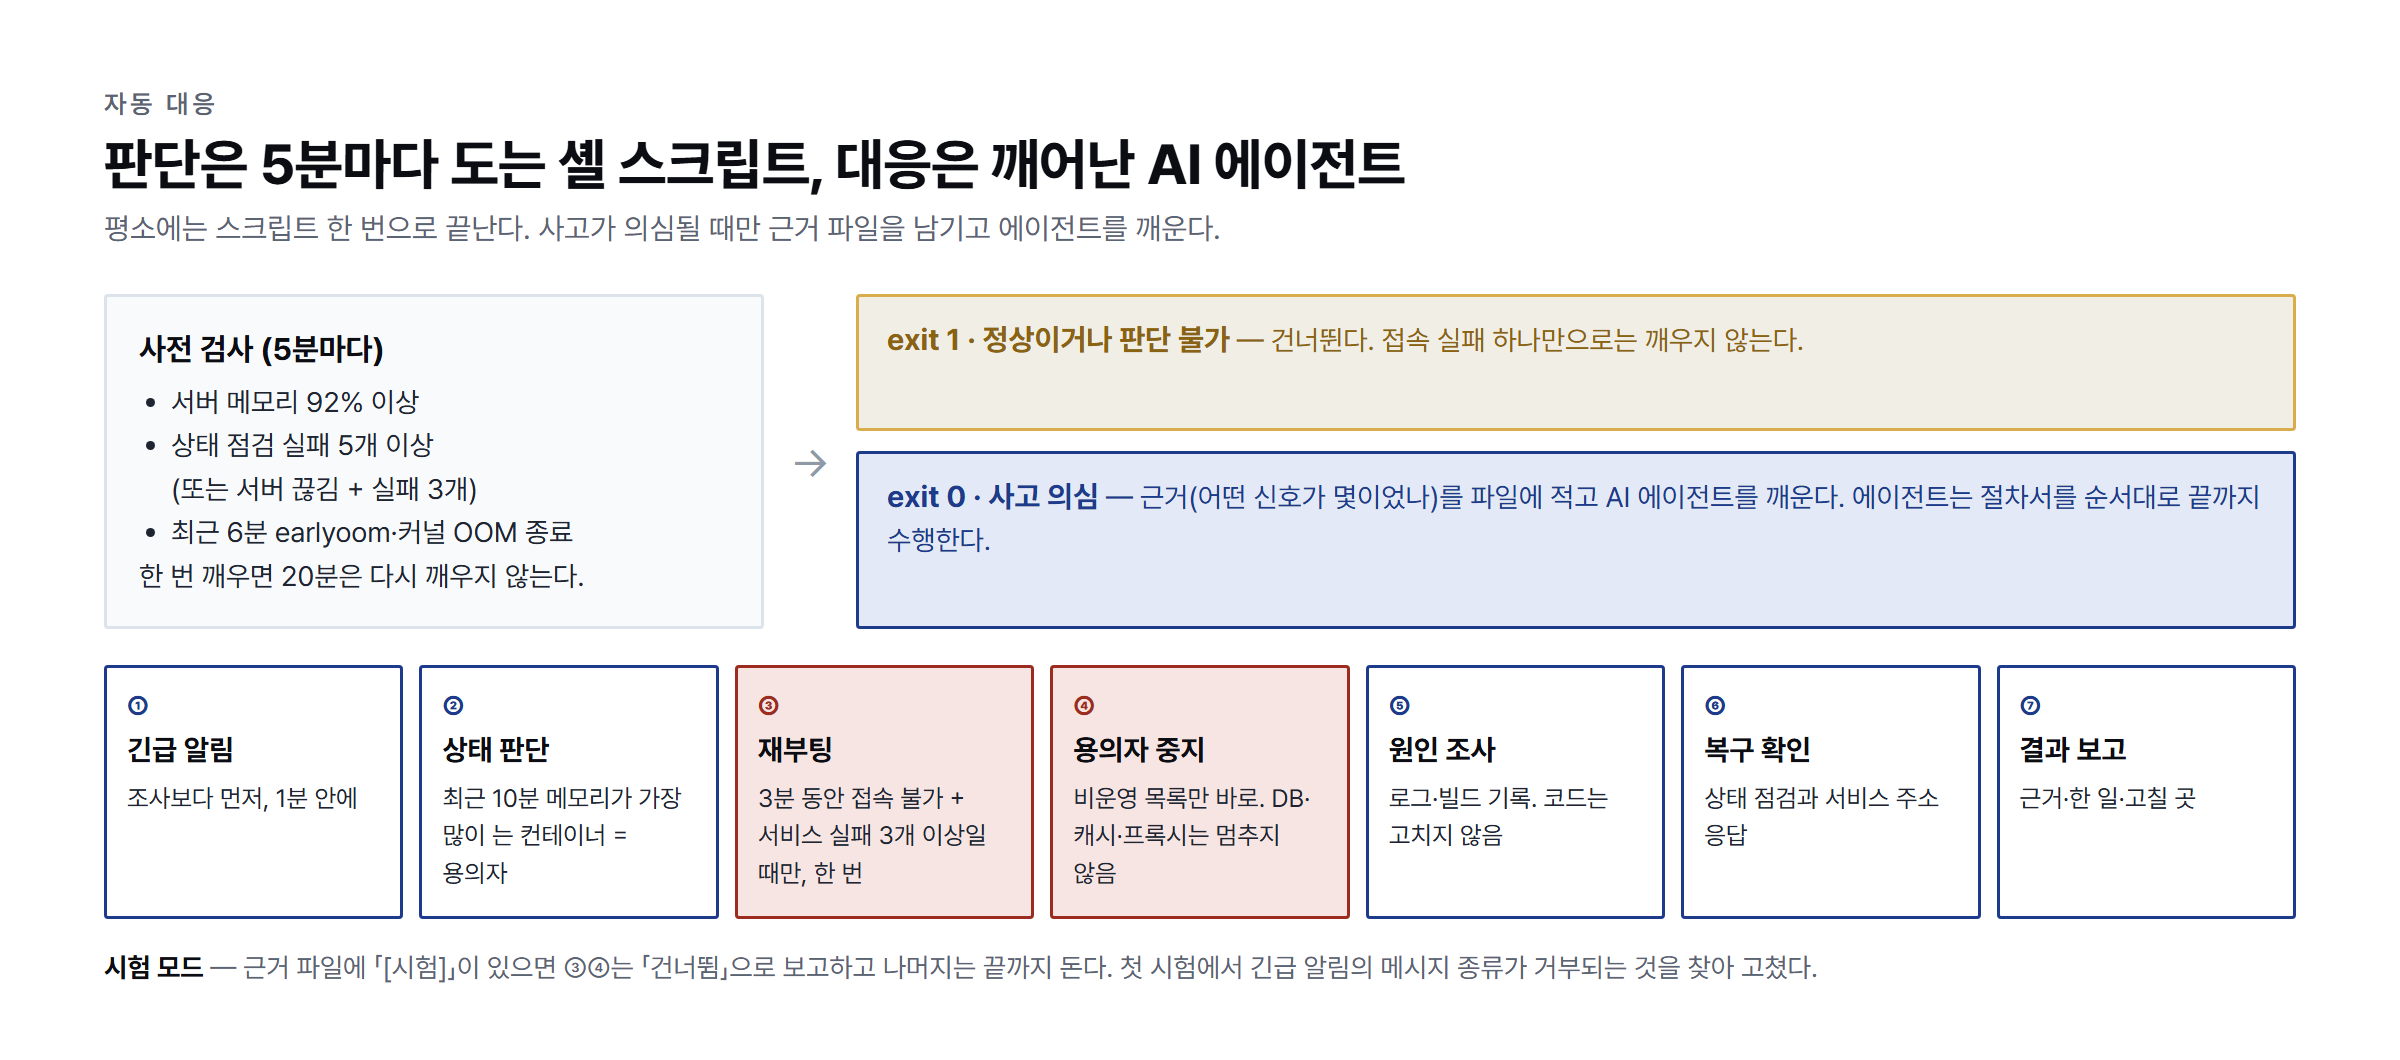
사전 검사와 에이전트 절차서의 흐름. 실제 스크립트와 절차서의 조건을 옮겨 그린 그림이며, 빨간 칸은 되돌리기 어려운 단계입니다.
시험 모드로 끝까지 리허설했습니다
사고 때 처음 돌려 보는 자동화는 믿기 어렵습니다. 그래서 근거 파일에 「[시험]」 표시를 남기면, 에이전트가 재부팅과 컨테이너 중지만 「시험이라 건너뜀」으로 보고하고 나머지 단계는 실제처럼 끝까지 돌게 했습니다.
사고 직후인 17:28에 첫 시험을 돌렸습니다. 에이전트는 서버에 접속해 메모리가 40.4%이고 최근 종료 기록이 없다는 것을 확인했고, 실제 상황이었더라도 멈출 근거가 없다고 판단했습니다. 이 판단은 맞았습니다. 그리고 1단계에서 문제가 하나 나왔습니다. 긴급 알림을 보낼 때 고른 메시지 종류가 보내는 쪽 조건에 맞지 않아 거부된 것입니다. 에이전트는 다른 종류로 다시 보내 알림을 전달했고, 그 내용을 보고에 남겼습니다. 절차서의 알림 명령은 그 결과대로 고쳤습니다. 리허설을 하지 않았다면 실제 사고 때 가장 먼저 해야 할 알림이 가장 먼저 실패했을 것입니다.
결과
- 공유 파이프라인의 명령 파일 이름과 쓰기 전 검사가 고쳐졌고, 시험 9건이 PR 검사에서 함께 돕니다.
- 운영 서버에 earlyoom과 비운영 컨테이너 우선순위, 빌드 에이전트 4GB 상한이 들어갔습니다. 시험 때 확인한 빌드 에이전트는 재부팅 뒤 새로 떠서 294MB를 쓰고 있었습니다.
- 5분마다 사전 검사가 돌고, 의심될 때만 에이전트가 깨어나 알림부터 보고까지 수행합니다. 시험 모드로 한 번 끝까지 돌렸습니다.
실패 줄을 PR 댓글로 다는 기능 자체는 그대로 씁니다. 작업자가 CI 콘솔 자격 없이도 실패 내용을 읽게 하는 요령은 팁 CI 실패 줄은 PR 댓글로 올려, 콘솔 자격 없이도 읽게 한다에 적었습니다. 이번 사고에서 나온 요령은 팁 세 개로 나눴습니다. 로그용 임시 명령 파일이 원본 스크립트와 같은 경로면 스크립트가 자기 자신을 부른다, earlyoom과 oom_score_adj로 「죽어도 되는 것」부터 끝낸다, 장애 대응 AI 에이전트는 싼 사전 검사가 이상을 볼 때만 깨운다입니다.
배운 것
- 운영을 멈춘 것은 큰 변경이 아니라 「로그를 조금 더 남기자」는 작은 변경이었습니다. 배포 경로에 끼어드는 변경은 크기와 상관없이 배포 경로를 바꾸는 변경입니다.
- 공유 파이프라인은 고치면 모든 저장소가 함께 좋아지지만, 망가뜨리면 모든 저장소가 함께 망가집니다. 이번에는 검사·이미지 단계는 멀쩡하고 배포 단계 하나만 겹쳐서, 배포가 실제로 돌기 전까지 드러나지 않았습니다.
- 원인을 찾은 순서는 「바깥 → 서버 → 컨테이너 → 빌드 → 코드」였습니다. 각 층에 기록이 남아 있었기 때문에 10분 남짓한 사고를 숫자로 되짚을 수 있었습니다. 서버가 멈춘 구간의 기록이 비어 있다는 것도 그 자체로 단서였습니다.
- 자동화는 리허설을 해 봐야 믿을 수 있습니다. 첫 시험에서 가장 먼저 실패한 것은 가장 단순한 단계인 알림이었습니다.
남은 한계
- 자동 대응은 시험 모드로만 끝까지 돌려 봤습니다. 실제 사고에서 재부팅이나 컨테이너 중지까지 간 적은 아직 없습니다.
- 용의자 판정은 「최근 10분 동안 메모리가 가장 많이 는 컨테이너」라는 단순한 규칙입니다. 몇 시간에 걸쳐 천천히 쌓이는 누수는 이 규칙으로 가려내기 어렵습니다.
- 사전 검사는 지표를 모으는 별도 모니터링 쪽에 닿아야 판단할 수 있습니다. 거기에 닿지 않으면 「판단 불가」로 건너뜁니다.