배포는 한순간이 아니다 — 옛 코드와 새 코드가 함께 도는 시간 견디기
무중단 배포 중에는 옛 코드와 새 코드, 옛 데이터와 새 데이터가 반드시 함께 돕니다. Daypage에서 겪은 두 사례(새 NOT NULL 컬럼, 필기 좌표 형식 변경)로 「넓히는 변경」과 「좁히는 변경」을 같은 배포에 넣지 않는 방법과, 그것을 PR 검사와 롤백에 묶어 둔 과정을 적었습니다.
배포는 한순간이 아니다
옛 코드와 새 코드가 함께 도는 시간을 견디는 expand/contract
배경 — 「배포했다」는 한 시점이 아니라 한 구간이다
배포 버튼을 누르면 새 버전이 「된다」고 생각하기 쉽다. 실제로는 그렇지 않다. 무중단 배포는 서버를 한 번에 갈아 끼우지 않고 차례로 바꾼다. 그 순서는 대략 아래와 같다.
이 단계가 이어지는 몇십 초에서 몇 분 동안, 어떤 요청은 옛 코드가 받고 어떤 요청은 새 코드가 받는다. DB는 맨 처음 단계에서 이미 새 스키마가 되어 있으니, 옛 코드가 새 스키마 위에서 도는 시간이 반드시 생긴다.
브라우저는 더 길다. 배포 전에 열어 둔 탭은 새로고침하기 전까지 옛 자바스크립트로 돈다. 사용자가 탭을 열어 둔 채 두면 그 시간에는 끝이 없다. 그 탭이 서버와 주고받는 데이터는 새 코드가 만든 데이터와 섞인다.
그래서 이 글의 핵심은 한 문장이다.
배포 중에는 옛 코드와 새 코드, 옛 데이터와 새 데이터가 함께 돈다. 그러니 넓히는 변경(expand)과 좁히는 변경(contract)을 같은 배포에 넣지 않는다.
아래는 이 원칙에 두 번 부딪히며 배운 기록이다. 하나는 DB 컬럼, 하나는 브라우저가 저장하는 데이터 형식이다.
무중단 배포의 실제 순서
- 마이그레이션이 순간부터 옛 코드 + 새 스키마
DB가 먼저 새 스키마가 된다
- 앱 서버 교체옛·새 코드가 섞여 요청을 받는다
하나씩 내리고 새 버전으로 올린다
- 정적 파일
새 프런트엔드 번들 배포
- 프록시 reload
새 서버 쪽으로 요청을 돌린다
- 백그라운드 워커
작업 큐 워커 교체
- 헬스 확인열린 탭은 이 뒤에도 옛 코드
실패하면 직전 이미지로 롤백
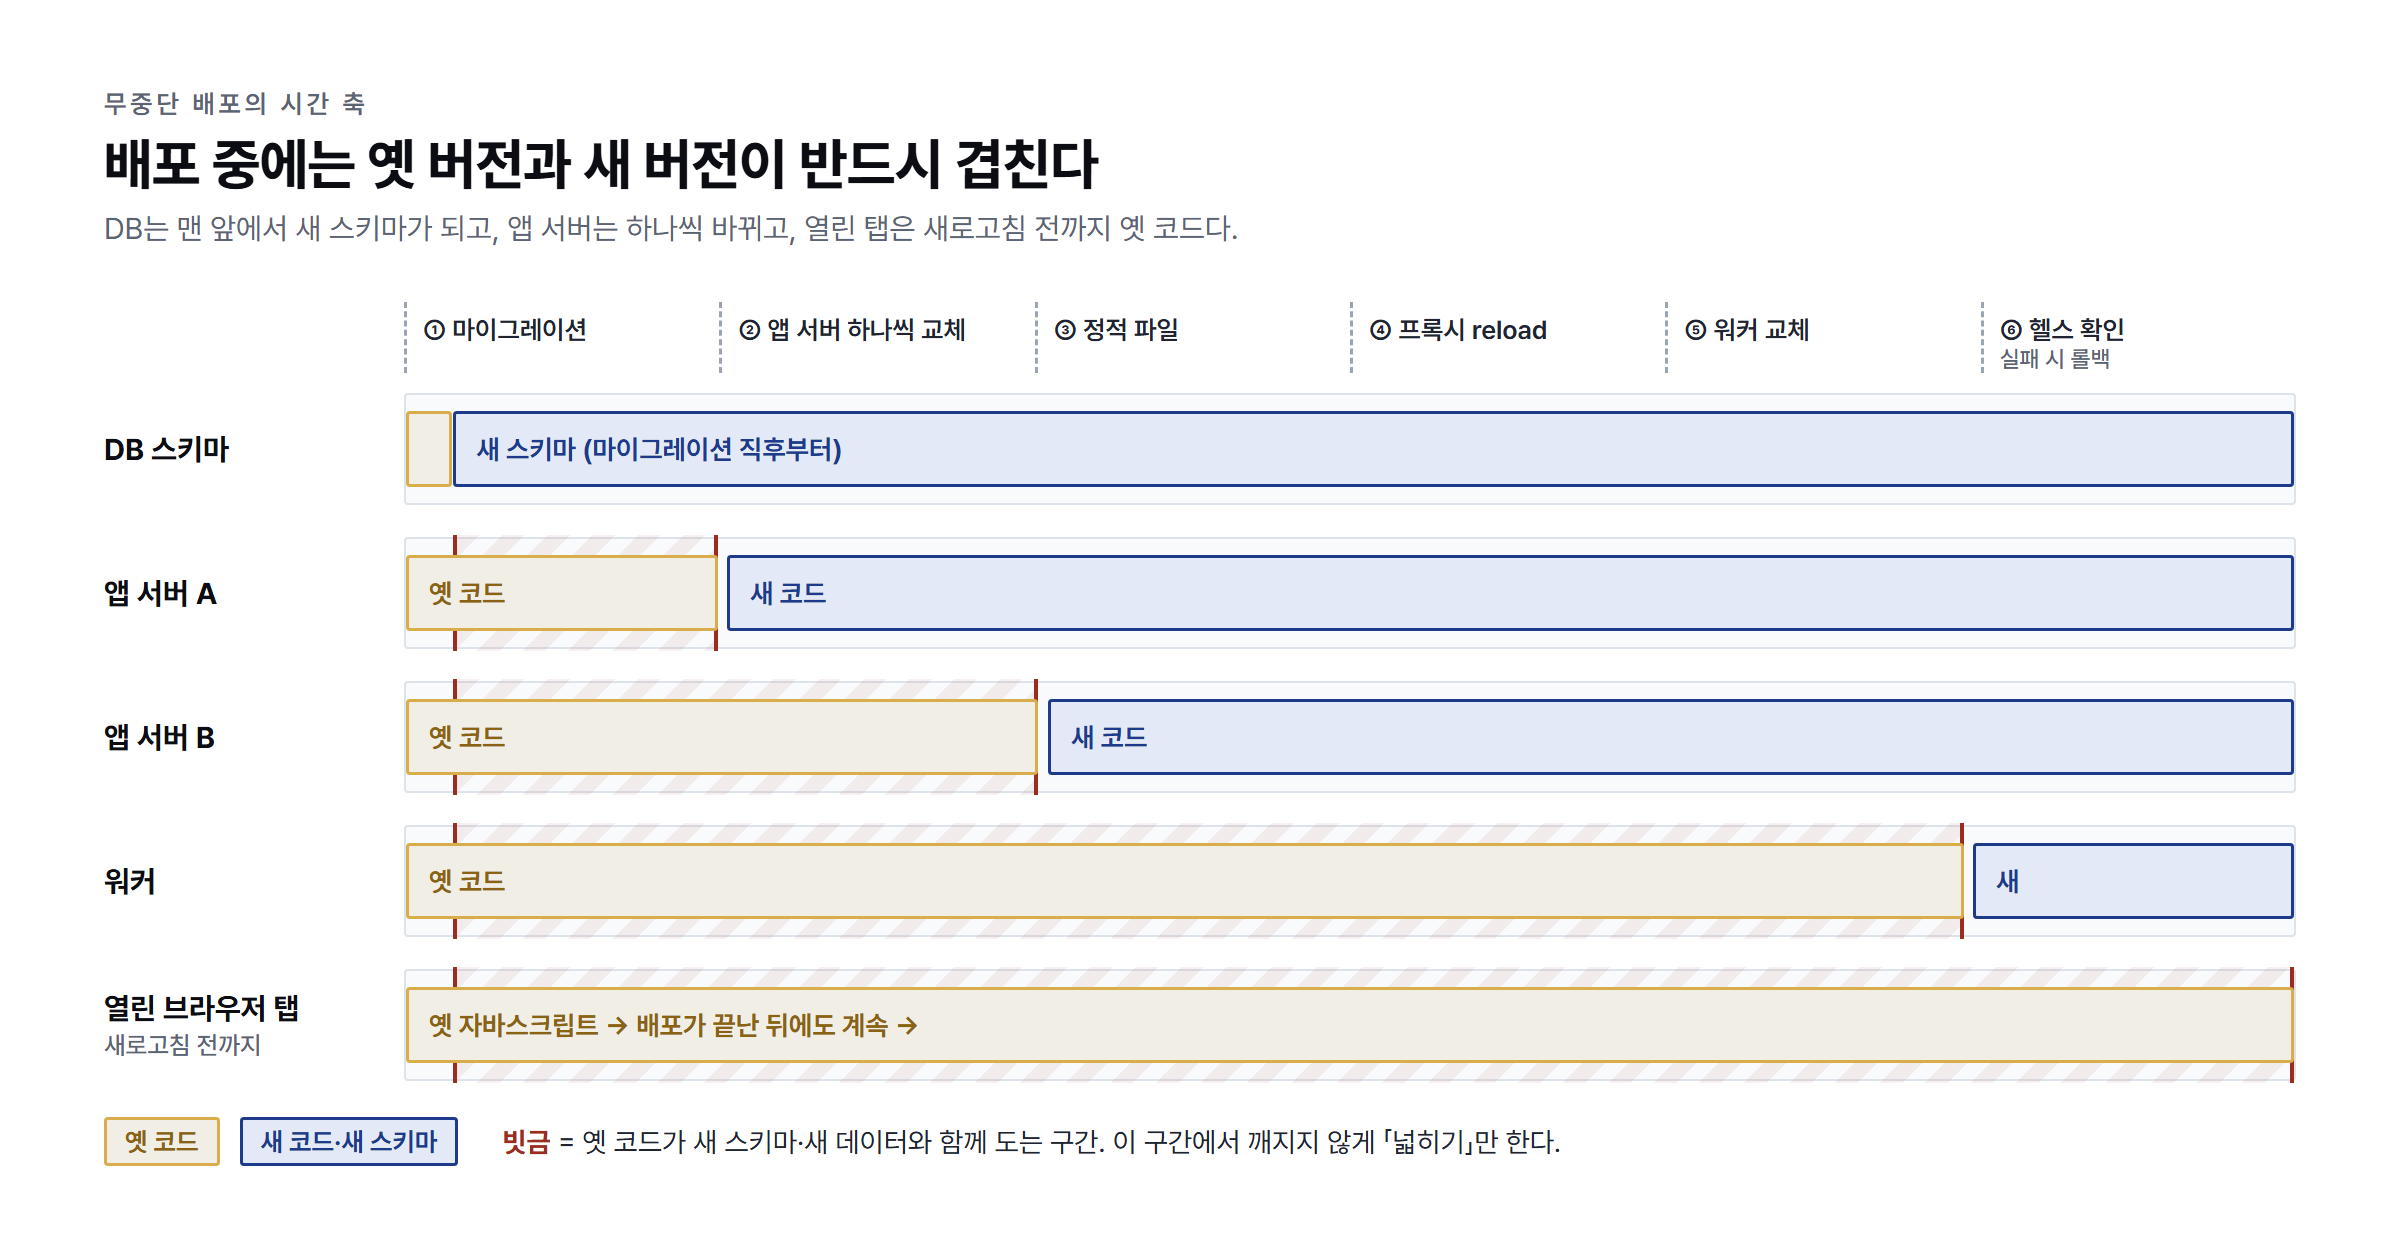
배포 단계마다 옛 코드와 새 스키마가 겹치는 구간(빗금). 구간 길이는 설명을 위한 것이고 실측값이 아니다. 직접 그린 그림.
사례 A — Daypage의 새 NOT NULL 컬럼과 db_default
증상
Daypage(Django)에서 사용자·노트 모델에 NOT NULL 필드를 추가해 배포했다. 배포하는 동안 null value in column ... violates not-null constraint 오류가 잠깐 쏟아지다가 멎었다.
원인
위 순서의 1번과 2번 사이 문제다. 마이그레이션이 먼저 돌아 컬럼이 생겼는데, 아직 교체되지 않은 앱 서버의 옛 코드는 그 컬럼을 모른다. 옛 코드의 INSERT에는 그 컬럼이 빠져 있다.
Django 모델의 default=는 파이썬 쪽 기본값이다. 새 코드가 객체를 만들 때 채워 줄 뿐, DB 테이블에는 기본값이 없다. 그러니 옛 코드의 INSERT는 DB에서 NOT NULL에 걸린다. 시험은 늘 「새 코드 + 새 스키마」 조합으로 돌기 때문에 이 구간을 보지 못한다.
해결 → DB에 기본값을 둔다
Django 5부터 생긴 db_default는 DB 열 자체에 DEFAULT를 건다. 파이썬 default와 함께 준다. 둘을 같이 두는 이유는, 새 코드에서는 객체를 만든 순간부터 값이 보여야 하고(default), 옛 코드의 INSERT에는 DB가 채워 줘야 하기(db_default) 때문이다.
from django.db import models
from django.db.models import Value


class Member(models.Model):
    # db_default: 배포 중 함께 도는 옛 코드가 이 열 없이 행을 만들어도 DB가 채운다
    is_staff = models.BooleanField(default=False, db_default=False)
    reason = models.CharField(max_length=200, blank=True, default="", db_default="")
    preferences = models.JSONField(
        default=dict,
        blank=True,
        db_default=Value({}, output_field=models.JSONField()),
    )
함정은 JSONField다. db_default={}처럼 파이썬 dict를 그냥 넘기지 않고 Value({}, output_field=models.JSONField())로 감싸서 JSON 값이라는 걸 알려 줘야 한다.
마지막으로 마이그레이션이 실제로 어떤 SQL이 되는지 눈으로 본다. sqlmigrate로 뽑아서 ADD COLUMN ... DEFAULT ... NOT NULL처럼 DEFAULT가 들어가 있으면 된다.
python manage.py sqlmigrate members 0042
기존 행에 계산한 값을 넣어야 할 때
상수 기본값으로 끝나지 않는 컬럼도 있다. 기존 행마다 다른 값을 계산해 넣어야 하는 경우다. 이때는 세 단계로 나눴다.
AddField(null=True)— NULL을 허용하는 컬럼으로 넓힌다.RunSQL로 기존 행을 채운다.AlterField로 NOT NULL로 좁힌다.
처음에는 셋을 한 마이그레이션에 넣었다. 그런데 따져 보면 3번은 좁히는 변경이다. 채우기가 끝난 뒤에도 옛 코드가 그 컬럼 없이 INSERT하면 NULL 행이 생기고, 그 상태에서 NOT NULL 전환이 돌거나 그 뒤 옛 코드가 INSERT하면 걸린다. 그래서 지금은 채울 때까지는 NULL 허용, NOT NULL 전환은 옛 코드가 사라진 다음 배포에서 하는 쪽이 더 안전하다고 본다.
# 배포 1: 넓히고 채운다
operations = [
    migrations.AddField("order", "total", models.IntegerField(null=True)),
    migrations.RunSQL(
        "UPDATE shop_order SET total = price * quantity WHERE total IS NULL",
        migrations.RunSQL.noop,
    ),
]

# 배포 2: 옛 코드가 사라진 뒤 좁힌다 (한 번 더 채우고 나서)
operations = [
    migrations.RunSQL(
        "UPDATE shop_order SET total = price * quantity WHERE total IS NULL",
        migrations.RunSQL.noop,
    ),
    migrations.AlterField("order", "total", models.IntegerField()),
]
이 내용은 팁 새 NOT NULL 컬럼에는 DB 기본값(db_default)을 준다에 짧게 정리해 두었다.
사례 B — Daypage의 필기 좌표 형식 바꾸기
DB만의 이야기가 아니다. 데이터를 만드는 쪽이 브라우저라면 옛 코드가 도는 시간은 훨씬 길어진다.
상황
Daypage는 여러 사람이 같은 문서에 동시에 손글씨를 쓰는 실시간 필기 앱이다. 문서는 CRDT(Yjs)로 동기화되고, 획(stroke) 하나는 좌표 목록 points를 가진다. 이 좌표를 숫자 배열에서 압축한 바이너리 문자열로 바꾸려 했다. 획이 많아질수록 문서가 커져서다.
무엇이 문제였나
CRDT 문서는 서버가 아니라 열려 있는 모든 탭이 함께 고친다. 형식을 한 번에 바꿔 배포하면 두 가지가 동시에 터진다.
- 새 코드가 바이너리로 쓴 획을, 새로고침하지 않은 옛 탭이 받는다. 옛 탭은 숫자 배열을 기대하므로 그 획을 그리지 못하거나 오류를 낸다.
- 거꾸로 옛 탭이 획을 옮기거나 지우면서 옛 형식으로 다시 쓴다. 새 형식으로 바뀐 데이터가 옛 형식으로 덮인다.
서버 마이그레이션처럼 「한 번에 다 바꾸는」 단계도 없다. 문서는 사용자들의 탭에 흩어져 있다.
해결 → 읽기를 먼저, 쓰기는 다음 배포
배포를 둘로 나눴다.
- 배포 1: 두 형식을 다 읽는다. 새 획은 여전히 옛 형식(숫자 배열)으로 쓴다.
- 기다림: 배포 1 이전 탭이 사라질 때까지. 새 버전 안내로 새로고침을 권하면 빨라진다.
- 배포 2: 상수(또는 기능 플래그) 하나를 켜서 새 획을 바이너리로 쓴다. 문제가 생기면 다시 끄면 된다.
- (선택) 배포 3: 옛 형식 읽기를 지운다. 옛 형식 획이 문서에 남아 있다면 지우지 않는다.
놓치기 쉬운 곳이 하나 있었다. 기존 획을 옮기거나 회전할 때다. 좌표를 읽어 바꾼 뒤 다시 쓰는데, 이때 플래그를 따라 쓰면 배포 1에서도 바이너리 획이 숫자 배열로 바뀌거나, 배포 2에서 옛 획이 갑자기 바이너리가 된다. 그래서 변형할 때는 그 획이 원래 쓰던 형식을 그대로 지킨다.
type Points = number[] | string;

// 배포 1에서는 false. 옛 탭이 사라진 뒤 배포 2에서 true로 바꾼다.
const WRITE_BINARY_POINTS = false;

// 두 형식을 다 읽는다
function readPoints(value: Points): number[] {
  return typeof value === 'string' ? decodeBinary(value) : value;
}

// 어떤 형식으로 쓸지는 부르는 쪽이 정한다
function writePoints(points: number[], binary: boolean): Points {
  return binary ? encodeBinary(points) : points;
}

// 새 획: 플래그를 따른다
function newStroke(drawn: number[]) {
  return { points: writePoints(drawn, WRITE_BINARY_POINTS) };
}

// 기존 획 옮기기: 그 획이 원래 쓰던 형식을 지킨다 (x, y가 번갈아 놓인 배열)
function moveStroke(stroke: { points: Points }, dx: number, dy: number) {
  const moved = readPoints(stroke.points).map((v, i) => v + (i % 2 === 0 ? dx : dy));
  stroke.points = writePoints(moved, typeof stroke.points === 'string');
}
encodeBinary/decodeBinary는 어떤 압축이든 된다. 중요한 건 형식 판별(typeof value === 'string')이 데이터 자체에 들어 있어서, 섞여 있어도 획마다 알아서 읽힌다는 점이다.
이 사례의 요령은 팁 저장·통신 형식을 바꿀 때는 읽기를 먼저 배포하고, 쓰기는 다음 배포에서로 따로 정리했다.
두 사례는 같은 모양이다
| 넓히기 (이번 배포) | 좁히기 (다음 배포) | |
|---|---|---|
| DB 컬럼 추가 | 컬럼 + DB 기본값, 또는 NULL 허용 | NOT NULL 전환 |
| DB 컬럼 삭제·이름 변경 | 코드에서 그 컬럼을 더 이상 쓰지 않기 | 컬럼 지우기·이름 바꾸기 |
| 저장 형식 변경 | 두 형식 다 읽기, 쓰기는 옛 형식 | 새 형식 쓰기 켜기 → 옛 형식 읽기 제거 |
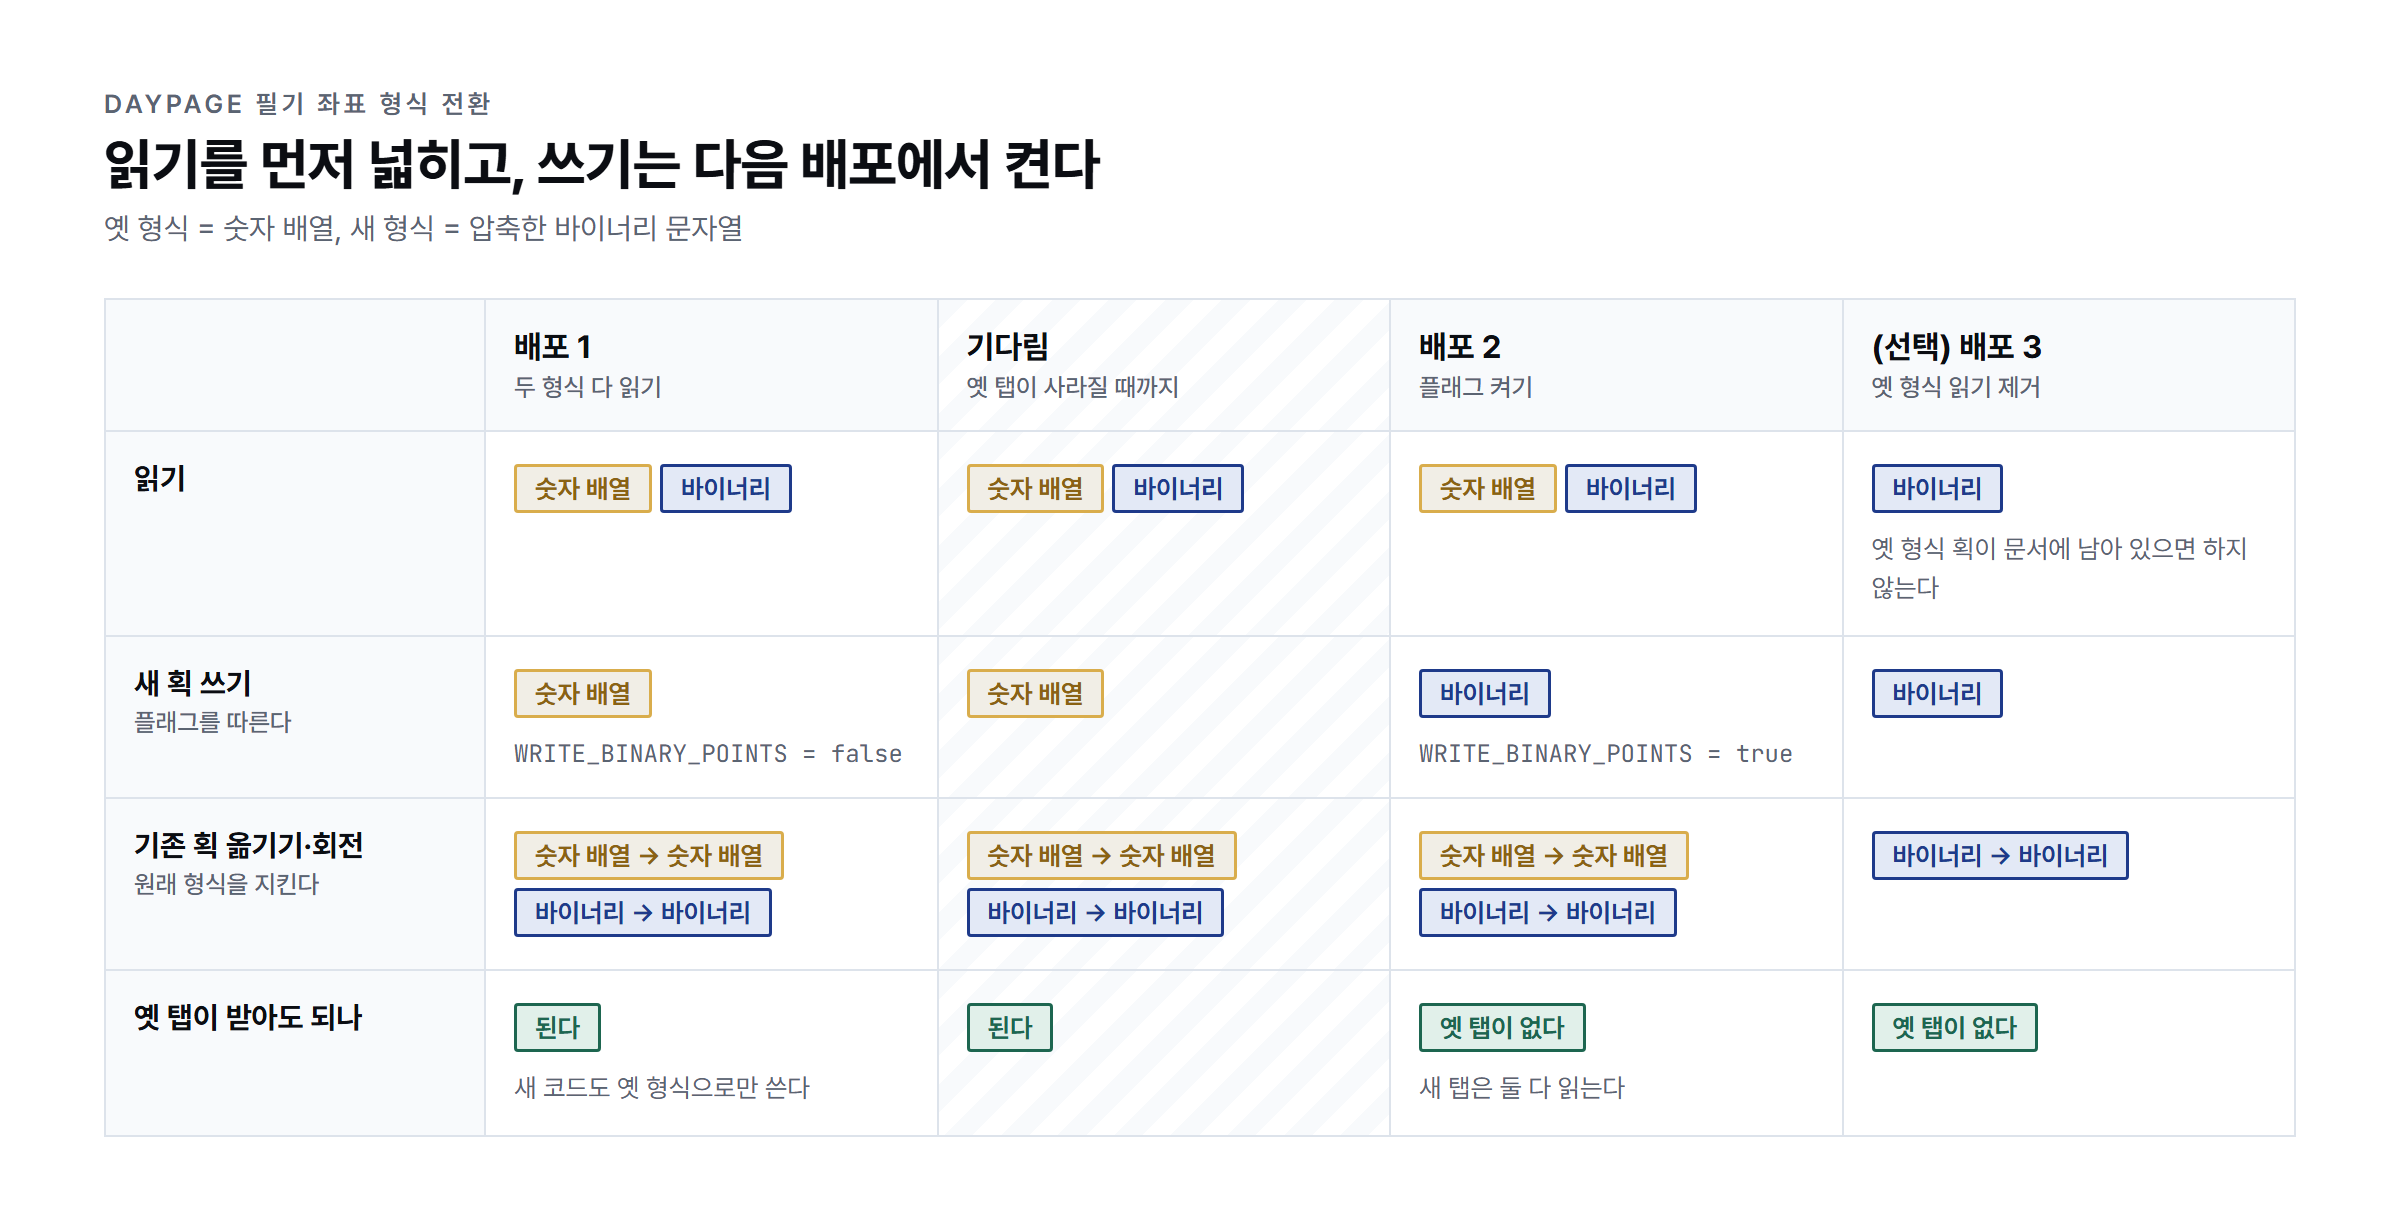
Daypage 필기 좌표 형식 전환: 읽기는 먼저 넓히고 쓰기는 다음 배포에서 켠다. 본문의 코드 규칙을 옮긴 그림.
사람이 기억하지 않게 — PR 검사가 위험한 마이그레이션을 막는다
원칙을 알아도 사람(과 AI 작업자)은 잊는다. 모델 필드를 지우면 makemigrations는 아무 말 없이 RemoveField를 만들어 준다. 그래서 PR이 열리면 CI가 그 PR에서 새로 생긴 마이그레이션만 훑어서, 좁히는 변경이 있으면 검사를 실패시키게 했다.
잡아내는 것은 아래와 같다.
PR 검사가 막는 변경
| 변경 | 왜 위험한가 |
|---|---|
| RemoveField, DeleteModel | 교체 전 옛 코드가 아직 그 컬럼·테이블을 읽고 쓴다 |
| RenameField, RenameModel | 옛 코드는 옛 이름으로 접근한다. DB 입장에선 지우기 + 만들기와 같다 |
| NULL 허용 → 불가 전환 | 옛 코드가 그 값 없이 INSERT하면 걸린다 |
| RunSQL 안의 DROP · RENAME | 위와 같은 일을 SQL로 직접 하는 경우 |
| db_default 없는 NOT NULL AddField | 사례 A의 오류가 그대로 난다 |
- 같은 PR에서 새로 만든 모델의 필드는 예외다. 그 테이블을 아는 옛 코드가 없으니까.
- 의도적인 좁히기 단계라면 마이그레이션에 정해진 「통과 표시」 주석을 달아 통과시킨다.
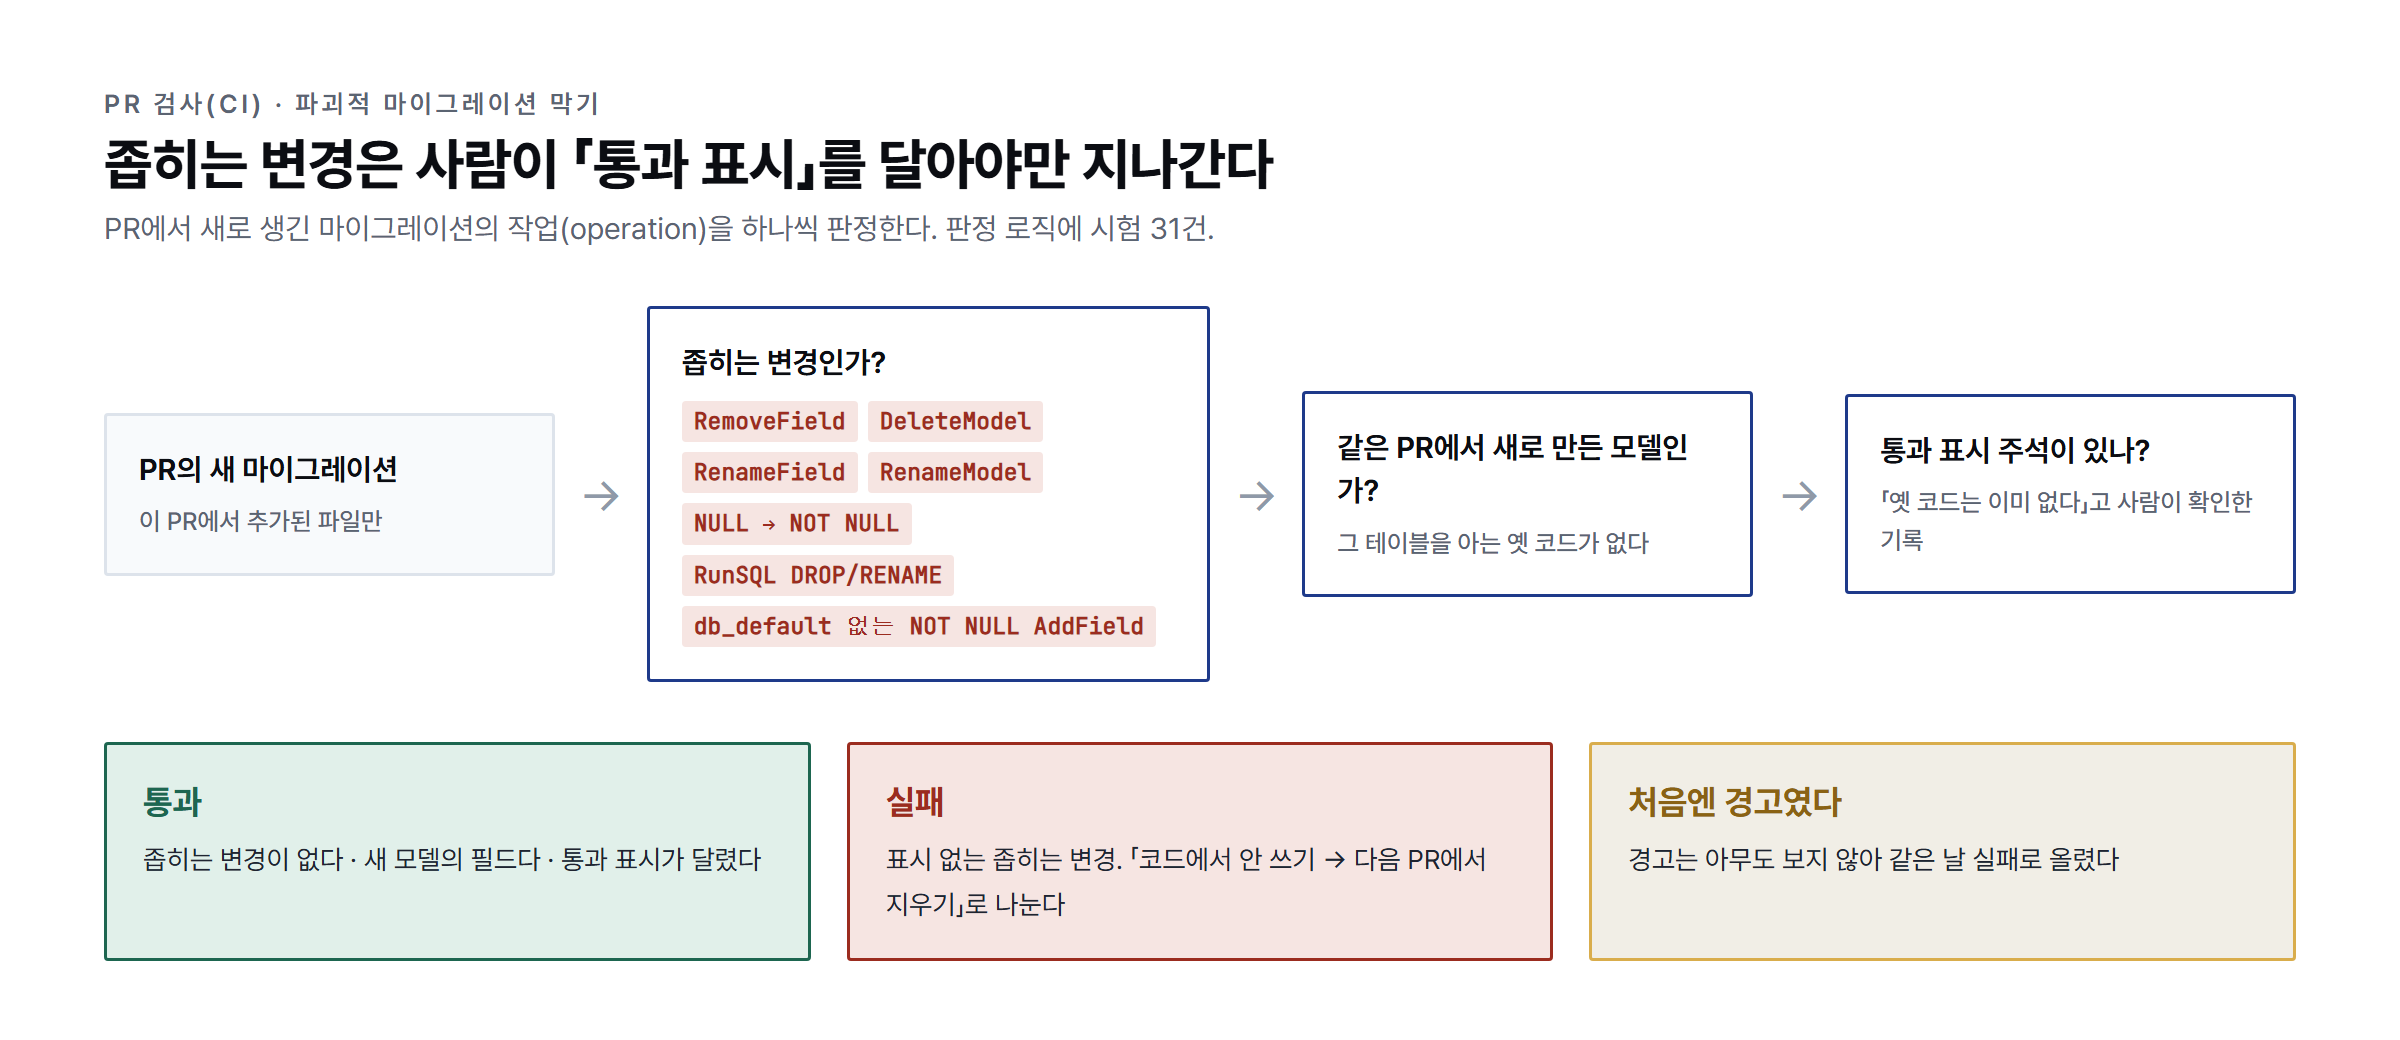
PR 검사가 마이그레이션을 판정하는 순서. 판정 규칙을 옮긴 그림이며, 실제 CI 화면이 아니다.
그래서 지우기는 자연스럽게 두 단계가 된다. 먼저 코드에서 그 컬럼을 쓰지 않게 하는 PR을 배포하고, 다음 PR에서 통과 표시를 단 RemoveField를 낸다. 통과 표시는 「이건 좁히기다, 옛 코드는 이미 없다」고 사람이 확인했다는 기록이 된다.
판정 로직에는 시험 31건을 붙였다. 마이그레이션 파일을 읽어 작업(operation)을 판정하는 부분이라, 오탐과 놓침을 시험으로 묶어 두지 않으면 금방 믿을 수 없게 된다.
처음에는 경고로 시작했다. 막지는 않고 PR에 메시지만 남기는 방식이다. 그런데 경고는 아무도 보지 않는다. 같은 날 바로 실패로 올렸다. 정말 의도한 좁히기라면 통과 표시 한 줄이면 되니, 막아도 잃는 것이 거의 없다.
되돌릴 때 — 넓히기만 했으니 옛 이미지가 그대로 돈다
배포 마지막 단계의 헬스 확인이 실패하면 직전 이미지로 자동 롤백한다. 이때 마이그레이션은 건너뛴다. 스키마를 거꾸로 되돌리지 않는다는 뜻이다.
처음엔 불안해 보일 수 있다. 새 스키마 위에 옛 이미지를 올리는 셈이기 때문이다. 하지만 위의 규칙을 지켰다면 이번 배포의 마이그레이션은 넓히기뿐이다. 컬럼은 늘었고 기본값이 있으며, 지워진 것은 없다. 옛 코드는 배포 중에 이미 이 스키마 위에서 돌았고, 롤백은 그 상태로 돌아가는 것뿐이다.
반대로 같은 배포에 컬럼 삭제가 섞여 있었다면 롤백은 더 큰 사고가 된다. 되돌린 옛 이미지가 이미 사라진 컬럼을 찾는다. 스키마까지 되돌리는 역마이그레이션은 지운 데이터를 살려 주지 못한다. expand/contract를 지키는 것은 배포 중의 오류를 막는 일이면서, 롤백을 안전하게 만드는 조건이기도 하다.
교체 순서도 시험으로 묶었다. 가짜 docker 명령을 두고 배포 스크립트를 돌려서, 중단 없이 하나씩 교체되는지, 롤백 때 migrate가 돌지 않는지를 확인하는 시험이 26건이다.
헬스 확인을 촘촘히 할수록 새 컨테이너가 준비됐다는 판정이 빨라져서 섞이는 구간도 짧아진다. 다만 평소에도 촘촘히 보면 그만큼 비용이 든다. 뜨는 동안만 촘촘히 보는 방법은 팁 헬스체크는 싸게, 뜨는 동안만 촘촘히에 적었다.
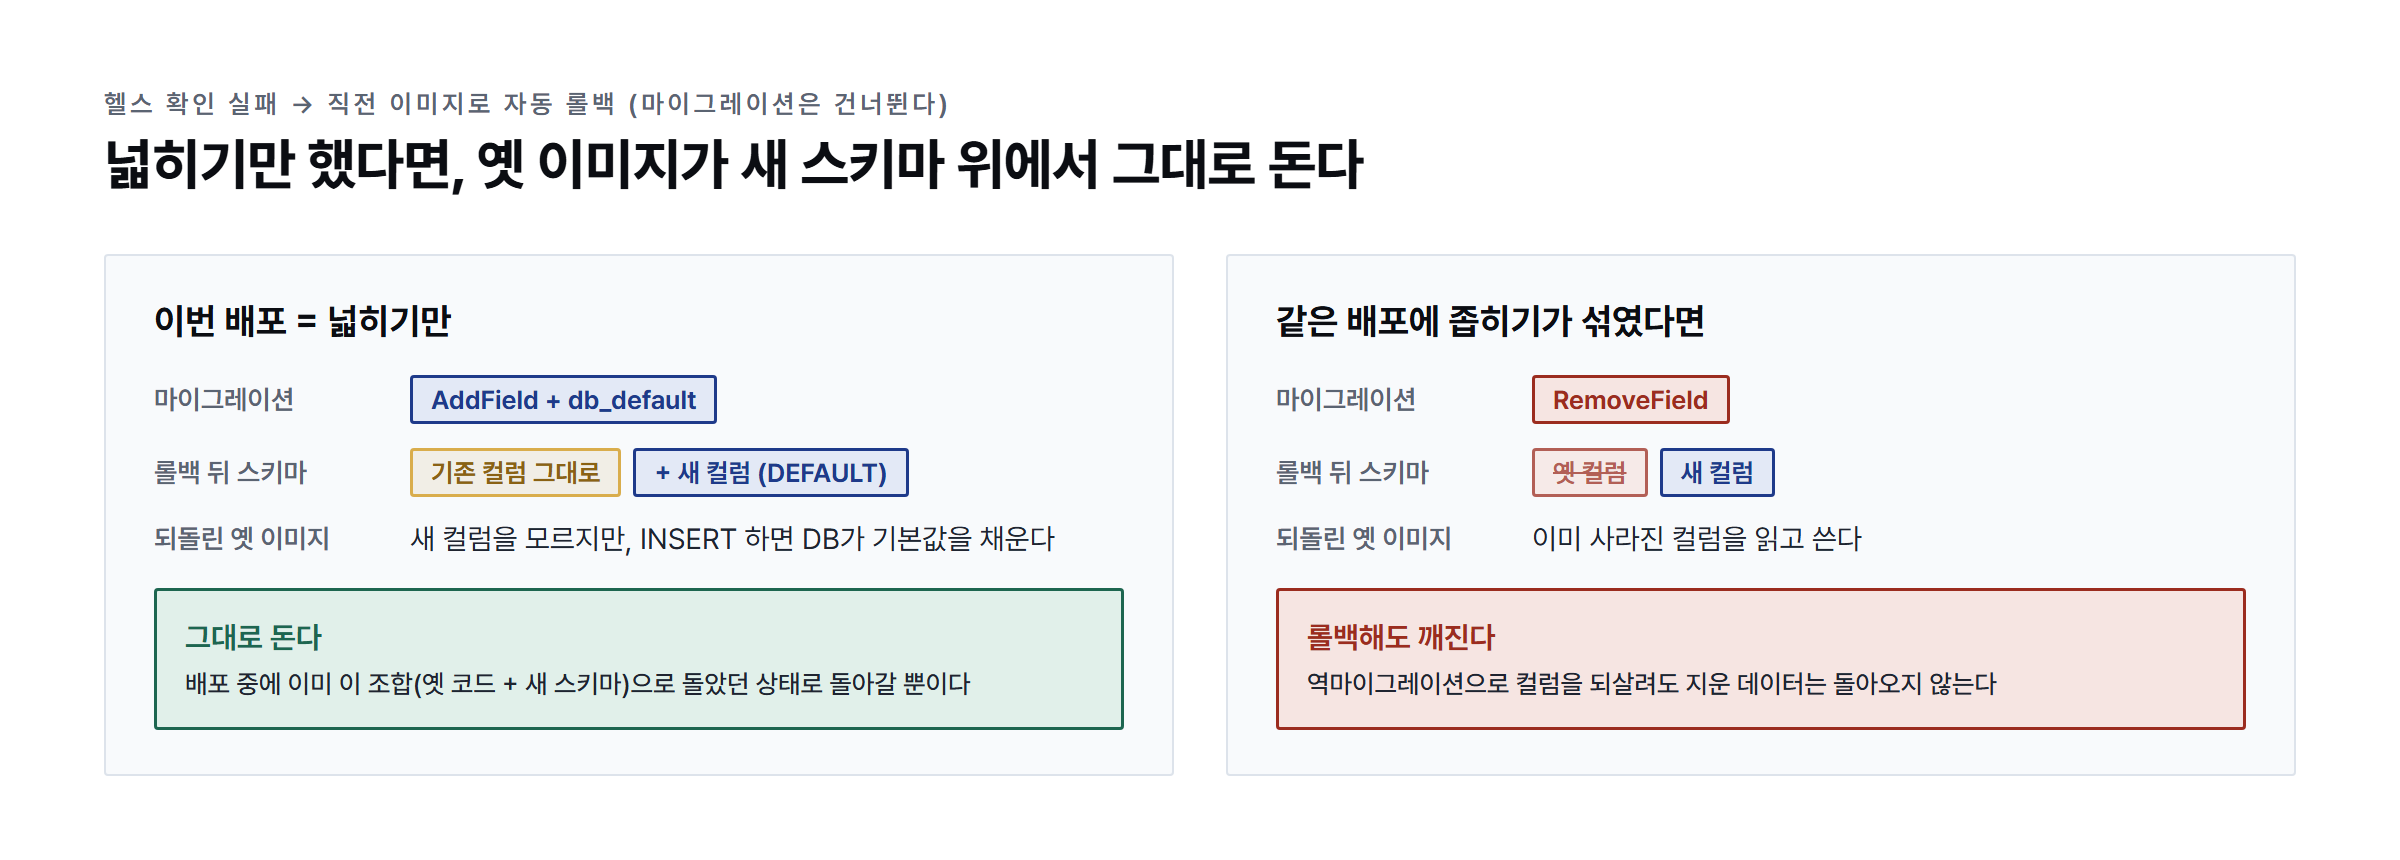
롤백은 마이그레이션을 건너뛰므로, 넓히기만 한 배포여야 옛 이미지가 새 스키마 위에서 돈다. 직접 그린 그림.
배운 것
- 시험은 「새 코드 + 새 스키마 + 새 데이터」만 본다. 배포 중에만 생기는 조합은 따로 생각하지 않으면 보이지 않는다. 배포하는 동안 오류가 잠깐 쏟아지다 멎으면 이 구간을 의심한다.
- 브라우저 탭은 배포의 일부다. 서버를 다 바꿔도 탭은 옛 코드로 남는다. 클라이언트가 데이터를 쓰는 앱이라면 「옛 코드가 도는 시간」을 서버 교체 시간이 아니라 탭이 살아 있는 시간으로 잡아야 한다.
- 원칙은 기억보다 검사가 지킨다. 그리고 경고가 아니라 실패여야 지켜진다.
- 배포를 둘로 나누는 건 느려 보이지만, 롤백까지 안전해지니 결국 덜 무섭게 배포할 수 있다.
남은 한계
- PR 검사는 Django 마이그레이션만 본다. 사례 B 같은 클라이언트 저장 형식 변경은 사람이 「읽기 먼저」를 지켜야 한다. 형식을 바꾸는 코드를 기계적으로 알아보기 어렵기 때문이다.
- 「옛 탭이 다 사라졌다」를 정확히 아는 방법은 마땅치 않다. 새로고침 안내로 줄일 수는 있어도, 다음 배포를 언제 해도 되는지는 판단이 필요하다.