AI 분류 필터를 바로 켜지 않았다 — 그림자 모드와 400건 평가로 기준을 고친 기록
Foresight의 편집자 AI가 처리하는 기사의 절반 이상이 주제 밖이라, 수집 단계에 규칙과 AI 판별을 두 겹으로 넣었습니다. AI 판별은 판정만 기록하는 그림자 모드로 먼저 배포하고 같은 400건으로 평가해, 실제로 쓴 기사를 잘못 버리는 비율을 5.6%에서 0.8%로 낮춘 뒤 켰습니다.
AI 분류 필터를 바로 켜지 않았다
그림자 모드와 400건 평가로 기준을 고친 기록
배경 — 편집자의 60개 자리를 주제 밖 기사가 차지했습니다
Foresight는 IT·AI 소식을 모아 기사로 정리하는 서비스입니다. 여러 RSS 소스에서 글을 수집해 두면, 편집자 AI가 하루 세 번 돌면서 최신순으로 60건을 읽고 묶어서 기사를 쓰거나 버립니다.
2026년 11월 5일 운영 기록을 보니 편집자가 일을 절반 넘게 헛도는 중이었습니다.
- 최근 세 번의 실행은 대기 124·110·144건에서 각각 60건을 처리했고, 그중 50·27·42건을 주제 밖으로 버렸습니다. 처리한 것의 45~83%가 버림이었습니다.
- 최근 7일 수집은 1,453건, 하루 약 207건으로 편집 처리 한도(하루 180건)를 넘었습니다.
- 같은 기간 버림 944건 가운데 편집자가 버린 것은 692건이고, 약 252건은 처리되지 못한 채 24시간이 지나 자동으로 버려졌습니다.
주제 밖 기사가 편집자의 60개 자리를 먼저 차지하는 동안, 정작 읽어야 할 기사는 차례가 오기 전에 만료되고 있었습니다. 편집자의 처리 한도나 일정을 늘리는 대신, 수집하는 순간에 주제 밖 기사를 걸러 내기로 했습니다.
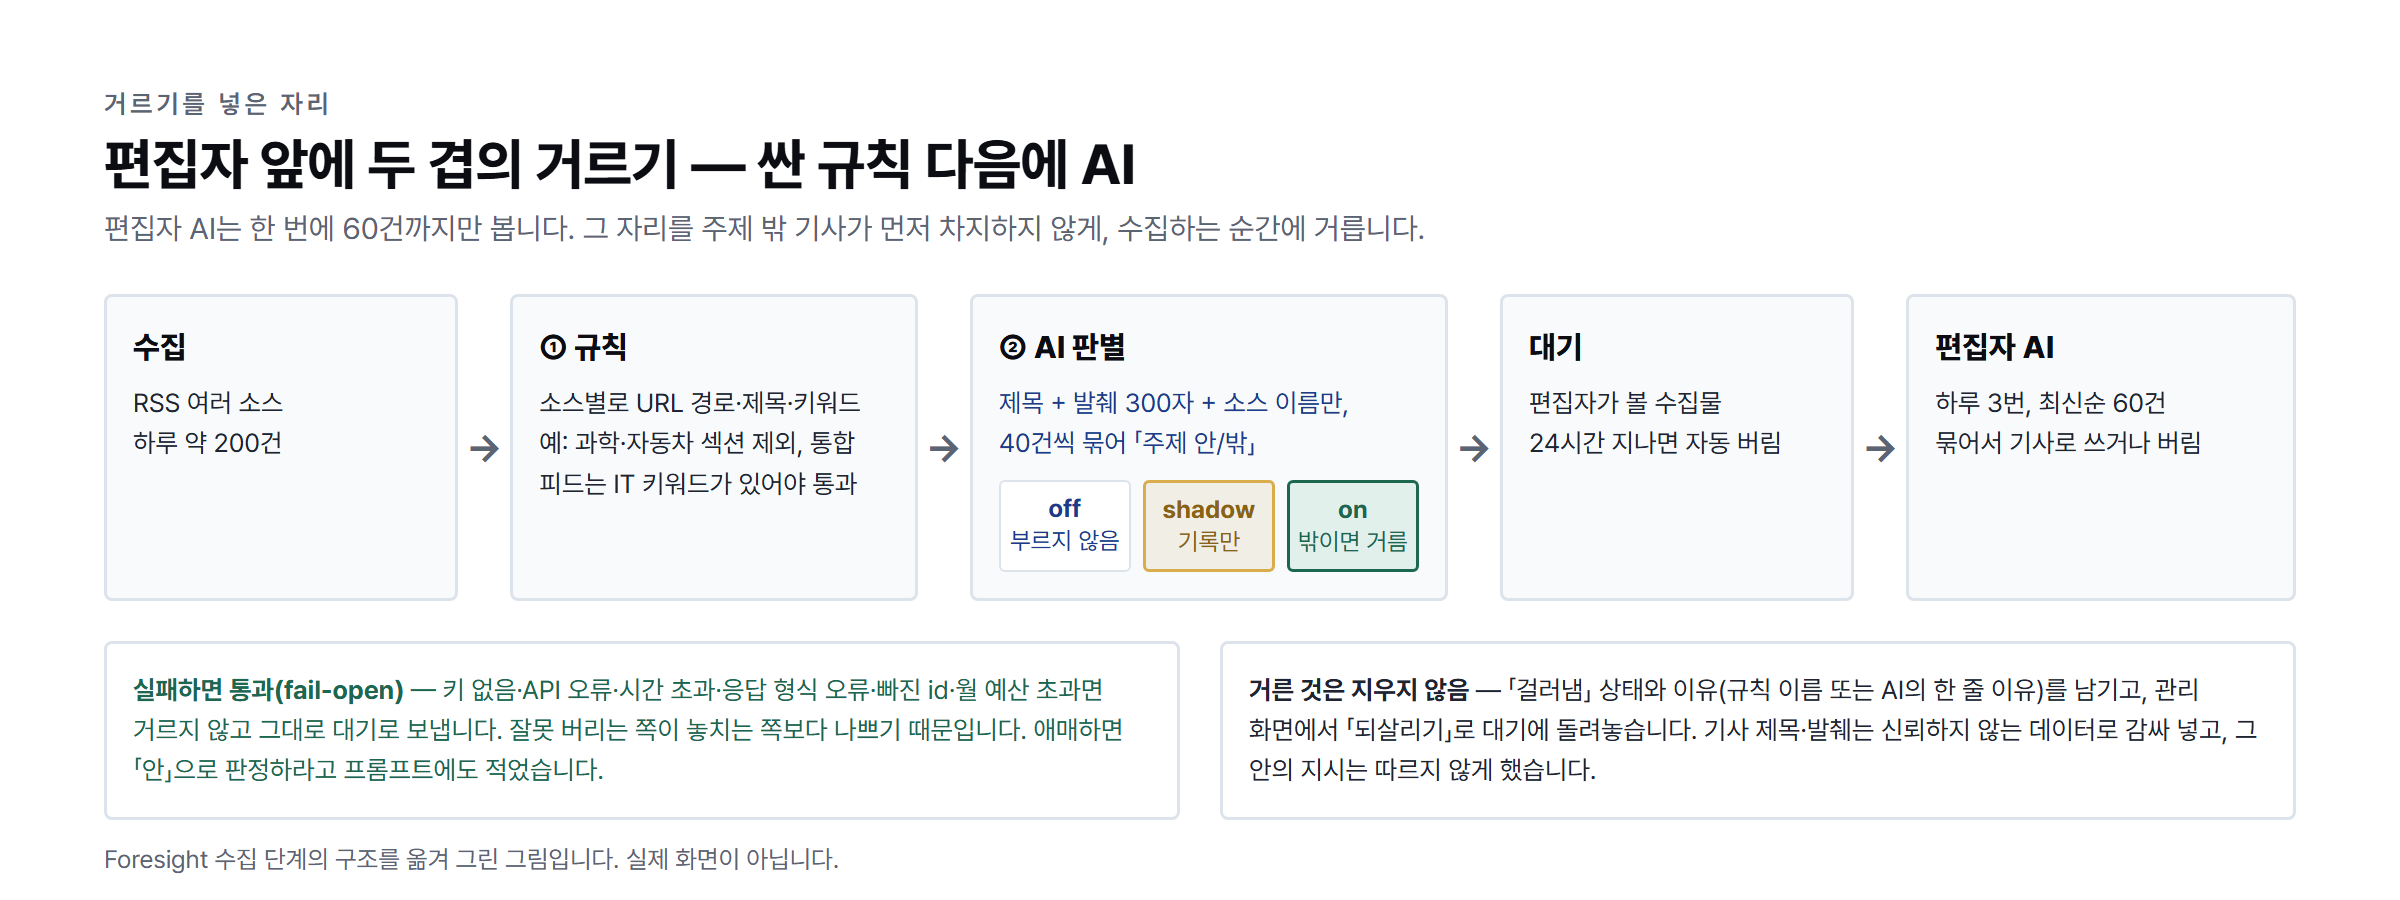
편집자 앞에 둔 두 겹의 거르기. Foresight 수집 단계의 구조를 옮겨 그린 그림이며 실제 화면이 아닙니다.
고른 방법 — 싼 규칙 다음에 AI, 그리고 기록만 하는 모드
① 소스별 규칙
먼저 돈이 들지 않는 규칙을 둡니다. 소스마다 「URL에 이 경로가 있으면 거름」, 「제목에 이 말이 있으면 거름」, 「제목과 발췌에 이 키워드가 하나도 없으면 거름」을 적습니다. 예를 들어 해외 매체 하나는 건강·자동차·우주·과학 섹션을 거르고, 게임·유통·식품·행사 기사가 섞인 국내 IT 매체의 통합 피드는 IT 키워드가 있어야 통과시킵니다.
넣기 전에 운영 수집물 전체에 규칙을 모의로 돌려 봤습니다. 491건이 걸러졌고, 편집자가 실제로 기사에 쓴 427건 가운데 걸리는 것은 10건(2.3%)이었습니다. 7일 기준 수집량이 약 25% 줄어 처리 한도 안으로 들어오는 수준입니다.
② AI 판별 — 작은 모델에 제목과 발췌만
규칙을 통과한 새 수집물만 Claude Haiku에게 「주제 안/밖」을 묻습니다.
- 입력은 제목 + 발췌 앞 300자 + 소스 이름뿐입니다. 원문을 가져오지 않고, 40건씩 묶어 구조화 출력(JSON 스키마)으로 답을 받습니다.
- 「이 사이트가 다루는 주제」는 코드에 고정하지 않고 DB의 분야 목록으로 만듭니다.
- 기사 텍스트는 신뢰하지 않는 데이터로 구분해 넣고, 그 안의 지시는 따르지 않는다고 시스템 프롬프트에 적었습니다. 모델에는 큰 DB id 대신 묶음 안 번호(1..n)를 주어 id를 잘못 베끼는 일을 막았습니다.
- 애매하면 「안」으로 판정합니다. 쓸 기사를 버리는 쪽이 잡음을 하나 더 남기는 쪽보다 나쁘기 때문입니다.
기본값은 「기록만」
AI 판별에는 세 모드를 두었습니다. off는 부르지 않고, on은 밖이면 거르고, shadow(그림자)는 판정과 이유를 기록만 하고 거르지 않습니다. 배포 기본값을 shadow로 두어, 배포하자마자 판정은 쌓이지만 실제로 버려지는 기사는 하나도 없게 했습니다.
평가 명령도 같이 만들었습니다. 편집자가 이미 내린 결정(기사에 씀 / 버림)을 정답으로 보고, 같은 프롬프트로 판별해 「쓴 기사를 밖으로 판정한 비율」과 「버린 기사를 밖으로 잡은 비율」, 한국어·영어별 혼동표, 비용을 출력합니다. 운영 DB는 읽기만 하고, 시험이 INSERT·UPDATE·DELETE가 0건인지 확인합니다.
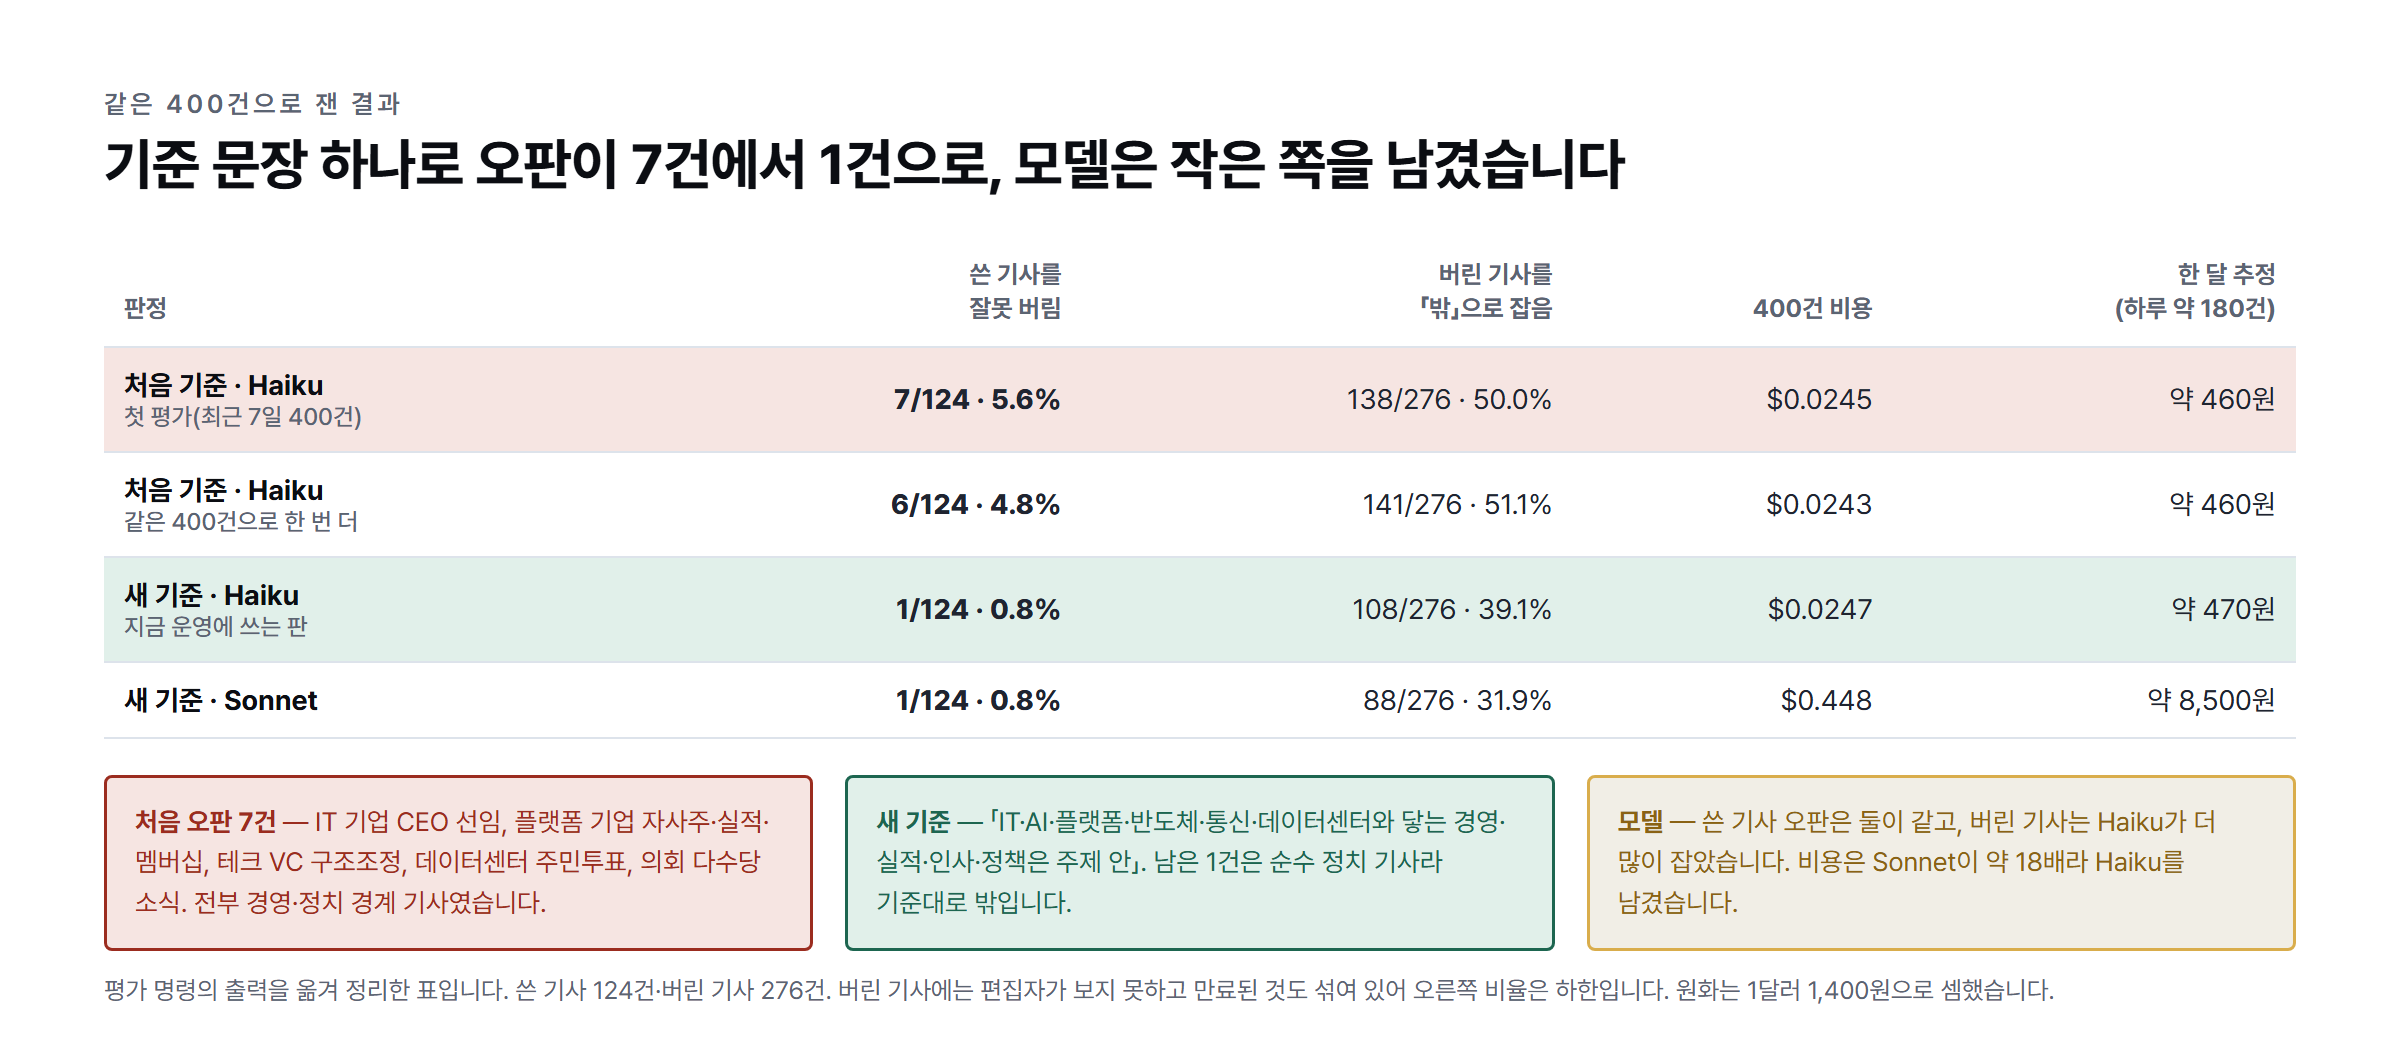
같은 400건(쓴 기사 124·버린 기사 276)으로 잰 평가 결과입니다. 평가 명령의 출력을 옮겨 정리한 표이며, 원화는 1달러 1,400원으로 셈했습니다.
부딪힌 문제와 해결
첫 평가는 요청 10건이 모두 401이었습니다
증상 — 배포 뒤 평가 명령을 돌리자 요청이 전부 인증 오류로 돌아왔습니다.
원인 — 넣어 둔 키가 sk-ant-로 시작하기는 했지만 API를 직접 부르는 콘솔 API 키가 아닌 다른 종류였습니다.
해결 — 콘솔 API 키로 바꾸고 컨테이너를 다시 만들었습니다. 이 사이 수집은 아무 문제 없이 돌았습니다. 판별이 실패하면 거르지 않고 통과하도록(fail-open) 짜 둔 덕분입니다. 키를 확인할 때는 값을 출력하지 않고 길이·접두·따옴표·공백만 봤습니다.
쓴 기사를 5.6% 버렸고, 전부 같은 종류였습니다
증상 — 최근 7일에서 뽑은 400건(쓴 기사 124·버린 기사 276)으로 평가하니, 편집자가 실제로 기사에 쓴 124건 가운데 7건(5.6%)을 「주제 밖」으로 판정했습니다. 한국어 기사는 7.5%로 더 높았습니다.
원인 — 잘못 버린 7건을 읽어 보니 모두 기업 경영·정치 경계에 있는 기사였습니다. IT 기업의 새 CEO 선임, 플랫폼 기업의 자사주 소각·분기 실적·멤버십, 테크 투자사의 구조조정, 데이터센터 입지를 두고 한 주민투표, 의회 다수당 소식입니다. 편집자는 이런 기사를 IT 산업 소식으로 썼지만, 판별 프롬프트에는 그 경계가 적혀 있지 않았습니다. 모델이 틀렸다기보다 기준이 비어 있었습니다.
해결 — 기준 문장을 더했습니다. 「경영·실적·인사·투자·구조조정·정책·규제·선거·주민투표라도 IT·AI·플랫폼·반도체·통신·데이터센터 산업이나 기업과 닿으면 주제 안, IT와 닿지 않는 순수 정치와 일반 사회·생활·연예·스포츠는 밖」. 예시는 한 줄로 짧게 두고, 「애매하면 안」과 보안 문단은 그대로 두었습니다.
첫 평가 집합을 읽기 전용 파일로 떠 두었기 때문에, 같은 400건으로 다시 잴 수 있었습니다. 새 기준에서 잘못 버린 쓴 기사는 1건(0.8%)으로 줄었고, 그 1건도 의회 다수당을 다룬 순수 정치 기사라 새 기준대로라면 밖이 맞습니다. 대가도 있습니다. 버린 기사를 밖으로 잡는 비율이 50%에서 39%로 내려갔습니다. IT 기업 경영 기사를 안으로 넓혔으니 당연한 값입니다.
큰 모델이 더 낫지 않을까
같은 400건을 Sonnet으로도 돌려 봤습니다. 쓴 기사 오판은 Haiku와 같은 1건이었고, 버린 기사를 밖으로 잡은 비율은 오히려 Haiku가 높았습니다(39.1% 대 31.9%). 비용은 400건에 Haiku $0.0247, Sonnet $0.448으로 약 18배입니다. 하루 약 180건으로 셈하면 한 달 약 470원과 약 8,500원입니다. 이 일에는 작은 모델이 충분해서 Haiku를 남겼습니다.
규칙 단계가 AI보다 먼저 주제 안 기사를 걸러 내고 있었습니다
증상 — 규칙을 켜고 처음 돈 운영 수집에서, 국내 통합 피드 30건 가운데 12건이 「IT 키워드 없음」으로 걸러졌습니다. 그중 게임 회사의 실적 기사 2건과 소프트웨어 회사 회장의 판결 기사 1건은 새 기준으로는 주제 안이었습니다. AI 평가에서 잘못 버렸던 플랫폼 기업 실적 기사도, 키워드 목록에 그 회사 이름이 없어서 AI에 닿기 전에 규칙에서 먼저 걸리고 있었습니다.
원인 — AI 기준을 넓혔는데 그 앞 단계의 키워드 목록은 옛 기준에 맞춰져 있었습니다. 두 겹의 거르기에서는 앞 단계가 뒷 단계보다 좁으면 뒷 단계를 아무리 고쳐도 소용이 없습니다.
해결 — 게임사·플랫폼 기업·핀테크·이커머스·영상 플랫폼·디스플레이·배터리 등 빠진 키워드를 더했습니다. 이미 관리 화면에서 고친 값을 지우지 않도록 기존 목록 끝에 빠진 것만 덧붙이는 데이터 마이그레이션으로 넣었고, 키워드 규칙을 아예 지운 소스에는 새로 만들지 않았습니다. 되돌릴 때는 이번에 더한 키워드만 뺍니다.
결과
- 새 기준으로 쓴 기사를 잘못 버리는 비율을 5.6%에서 0.8%로 낮춘 뒤 거르기를 켰습니다. 모델은 Haiku, 비용은 한 달 약 470원으로 추정합니다.
- 켜기 전 그림자 모드 동안 실제로 버려진 기사는 없었습니다. 401 사고도 수집에는 영향을 주지 않았습니다.
- 규칙 거르기가 처음 반영된 뒤 첫 편집자 실행은 대기 115건에서 시작해 57건을 남겼습니다. 거르기 전 세 번은 매번 50~84건이 남았습니다. 다만 이때는 거르기 전에 쌓인 대기가 아직 남아 있어 공정한 비교는 아닙니다.
- 판별 모델과 모드는 이제 관리 화면의 운영 설정에서 재시작 없이 바꿀 수 있습니다. 평가 명령도
--model로 다른 모델을 재 볼 수 있습니다.
배운 것
- 무언가를 「버리는」 AI 기능은 기록만 하는 모드로 먼저 내보냅니다. 배포와 켜기를 떼면, 켜기 전에 운영 데이터로 재 볼 시간이 생깁니다.
- 평가의 정답은 이미 있었습니다. 편집자가 쓴 기사와 버린 기사가 곧 라벨입니다. 새로 라벨을 만들지 않고도 「쓸 것을 버리는가」를 잴 수 있었습니다.
- 평가 집합을 고정해 두어야 기준을 고친 효과와 모델을 바꾼 효과를 갈라 볼 수 있습니다. 같은 400건으로도 실행마다 7건과 6건처럼 조금 흔들리니, 작은 차이는 신중하게 읽습니다.
- 오판은 모아 읽으면 모델이 아니라 기준의 빈칸을 가리키는 경우가 많습니다. 큰 모델로 바꾸기 전에 기준 문장부터 봅니다.
- 거르기를 여러 겹 두면 기준을 한꺼번에 고칩니다. 앞 단계가 더 좁으면 뒷 단계를 고친 보람이 없습니다.
남은 한계
- 평가의 정답은 편집자 AI의 판단입니다. 편집자가 잘못 쓴 기사나 잘못 버린 기사가 있다면 그 오류는 평가에 그대로 들어갑니다.
- 「버린 기사를 밖으로 잡은 비율」은 하한입니다. 버린 기사에는 편집자가 보지도 못하고 만료된 주제 안 기사가 섞여 있기 때문입니다.
- 평가는 400건, 한 시점의 집합입니다. 뉴스의 결이 바뀌면 다시 재야 합니다.
- 거르기가 편집자의 남는 건수를 얼마나 줄였는지는 아직 공정하게 재지 못했습니다. 거르기 전에 쌓인 대기가 다 빠진 뒤의 실행으로 다시 비교해야 합니다.
- 규칙 단계의 키워드 목록은 사람이 관리해야 합니다. 새 회사·새 분야가 나오면 다시 빠질 수 있고, 그때는 관리 화면의 「걸러냄」 목록을 보고 되살려야 합니다.